Un plan de site XML est souvent traité comme une formalité : une extension le génère, on le déclare une fois, on n'y revient jamais. Cette approche fait passer à côté de son usage le plus utile, qui n'est pas la découverte des pages mais le diagnostic. Un fichier unique contenant dix mille adresses indique seulement qu'un certain nombre d'entre elles sont indexées, information sans valeur opérationnelle. Les mêmes adresses réparties en huit fichiers par type de contenu permettent de voir immédiatement quelle famille de pages pose problème. Cet article détaille les principes de ce découpage, les questions de taille et de fréquence, et la façon de lire les rapports qui en découlent.
Pourquoi découper
Le découpage ne change rien à la découverte des pages : un moteur traite un fichier de dix mille adresses aussi bien que dix fichiers de mille. Le bénéfice est entièrement du côté de la lecture des résultats, ce qui en fait un outil de pilotage plutôt qu'un outil technique. Les fondamentaux de ce fichier sont rappelés dans notre article sur le fichier sitemap.xml, sa définition et sa création.
Le taux d'indexation par famille
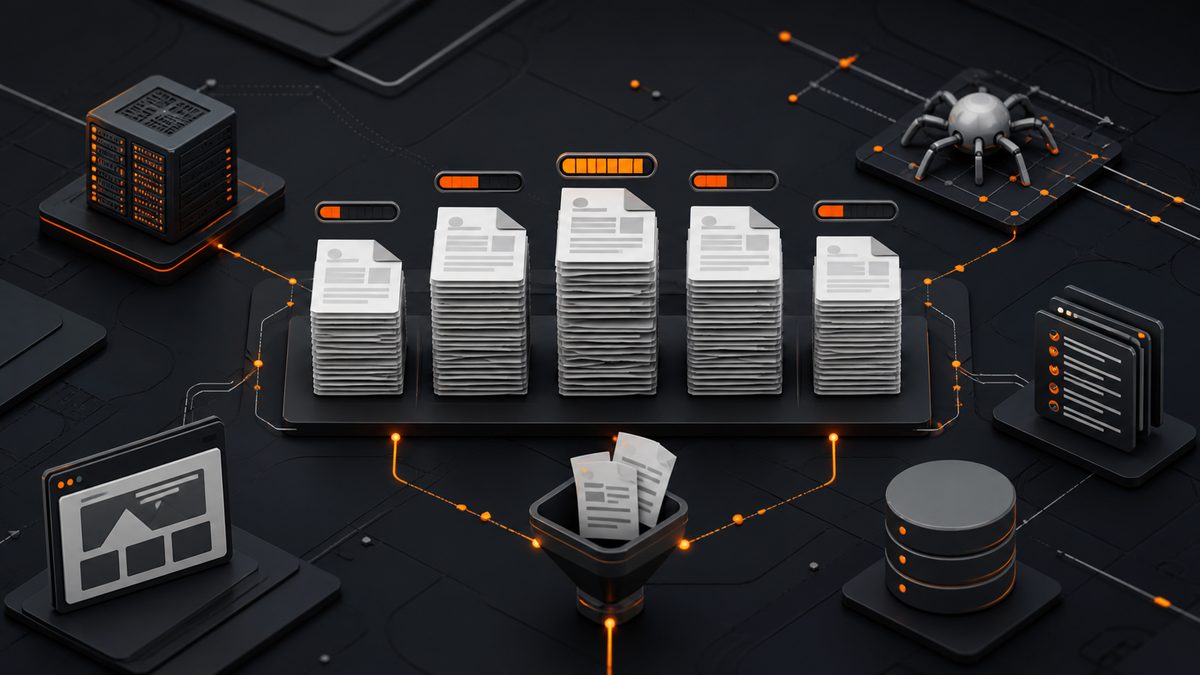
Les rapports d'indexation permettent de filtrer par sitemap, ce qui donne un taux d'indexation par fichier. Avec un découpage par type, ce taux devient une information exploitable : quatre vingt quinze pour cent sur les articles, soixante pour cent sur les fiches produit, vingt pour cent sur les pages de catégorie. Ce seul tableau oriente le travail bien mieux qu'un chiffre global. Sans découpage, cette information n'est tout simplement pas disponible. Le chiffre global masque en effet les écarts entre familles, qui sont précisément ce que l'on cherche à connaître. Un taux moyen de quatre vingts pour cent peut recouvrir aussi bien une situation homogène qu'une famille entière laissée de côté.
Isoler une régression
Lorsqu'une intervention technique dégrade l'indexation, un découpage fin permet de savoir immédiatement quelle famille est touchée. Un fichier unique montre une baisse sans en indiquer l'origine, ce qui oblige à chercher à l'aveugle. Cette capacité de localisation vaut à elle seule le temps consacré à la mise en place. Elle se révèle particulièrement précieuse après une refonte, moment où plusieurs choses changent simultanément. Disposer d'un relevé par famille pris avant la bascule transforme alors le diagnostic en simple comparaison. Sans ce point de départ, il faut reconstituer l'historique à partir d'impressions.
Mesurer une action ciblée
Une campagne d'enrichissement portant sur une catégorie de contenus se mesure directement si cette catégorie dispose de son propre fichier. Le taux d'indexation avant et après donne un chiffre défendable, là où une mesure globale noierait l'effet dans la masse. Cette possibilité change la façon dont on peut rendre compte du travail effectué. Elle suppose évidemment d'avoir découpé avant de commencer. Mettre en place le découpage quelques semaines avant une campagne fait partie de la préparation au même titre que le calendrier éditorial. Le coût est faible et le bénéfice porte sur toute la durée du chantier.
Repérer les familles oubliées
Un site accumule au fil des ans des types de contenus créés pour un besoin ponctuel puis délaissés. Le découpage les fait apparaître explicitement, avec leur volume et leur taux d'indexation. Il n'est pas rare de découvrir ainsi trois cents pages d'un type dont plus personne ne se souvient. Cette revue est un effet secondaire bienvenu de l'exercice. Elle conduit régulièrement à des décisions de nettoyage qui améliorent l'ensemble du site, indépendamment de toute question de sitemap. Un type de contenu que plus personne n'alimente mérite d'être archivé ou supprimé plutôt que maintenu à moitié.
Prioriser l'exploration
Un site volumineux voit son exploration se répartir inégalement. Séparer les contenus à forte valeur des contenus secondaires permet d'observer si cette répartition correspond aux priorités commerciales. Le sitemap ne pilote pas directement cette répartition et il rend le déséquilibre visible, ce qui est la première étape pour le corriger, en lien avec les principes exposés dans notre article sur l'indexation Google et ses mécanismes.
Faciliter la maintenance
Un fichier par type simplifie la génération et le débogage. Une anomalie dans le fichier des produits n'affecte pas celui des articles, et la régénération peut être partielle. Sur un site où la production des fichiers est coûteuse, cette granularité permet de ne recalculer que ce qui a changé. Le gain technique est modeste et réel. Il devient sensible sur les sites où la génération complète prend plusieurs minutes et bloque d'autres traitements. Découper permet alors d'étaler la charge sur la journée.
Les principes de découpage
Le découpage utile suit la logique éditoriale du site plutôt qu'une règle abstraite. Le critère à retenir est simple : deux familles doivent être séparées si l'on souhaite pouvoir comparer leurs taux d'indexation. Tout le reste en découle.
Par type de contenu
C'est le découpage de base : articles, pages, produits, catégories, étiquettes, chacun dans son fichier. Il correspond à la structure interne du site et il se génère automatiquement sur la plupart des systèmes de gestion de contenu. Il suffit dans la grande majorité des cas et constitue le point de départ à retenir. Les découpages plus fins viennent ensuite, si le volume le justifie. Commencer simple et affiner à l'usage évite de construire une architecture compliquée dont personne ne se sert. La bonne question à se poser est de savoir quelle comparaison manque aujourd'hui.
Par rubrique sur les gros volumes
Sur un catalogue de cinquante mille produits, un fichier unique de produits redevient opaque. Découper par famille de produits, ou par grande rubrique, restaure la lisibilité. Ce découpage demande un peu de développement lorsque le système ne le propose pas nativement. Il se justifie dès que le volume d'un type dépasse quelques milliers d'adresses. Le découpage doit alors suivre la structure commerciale du catalogue plutôt que l'ordre alphabétique ou l'identifiant, afin que les comparaisons obtenues aient un sens pour l'équipe.
Par date sur les publications
Un site publiant beaucoup peut découper ses articles par année, ce qui isole les contenus récents des archives. L'intérêt est double : mesurer l'indexation des nouveautés séparément, et éviter de régénérer un fichier de plusieurs milliers de lignes chaque jour. Les fichiers d'archives deviennent alors quasiment statiques. C'est un découpage particulièrement adapté aux médias et aux blogs anciens. Il permet aussi de mesurer si les contenus anciens restent indexés dans le temps, question rarement suivie et pourtant instructive sur la santé d'un site.
Séparer les images et les vidéos
Les fichiers dédiés aux médias suivent une spécification distincte et méritent leur propre fichier. Les mêler aux pages complique la lecture et la génération. Sur un site où le trafic image compte, cette séparation permet de suivre l'indexation des visuels indépendamment. Sur un site où elle ne compte pas, ces fichiers peuvent simplement être omis. Les produire sans jamais consulter leurs résultats représente un travail de génération sans contrepartie.
Ce qu'il ne faut pas y mettre
Un sitemap ne doit contenir que des adresses canoniques, renvoyant un code de succès, indexables et destinées à l'être. Y placer des pages redirigées, des pages en erreur, des pages interdites d'indexation ou des variantes non canoniques produit des avertissements et brouille le signal. Cette règle paraît évidente et elle est violée sur la majorité des sites audités. Le cas des boutiques est particulièrement parlant, comme nous le détaillons dans notre article sur le sitemap WooCommerce et ce qu'il faut en exclure.
L'index de sitemaps
Dès que plusieurs fichiers existent, un fichier d'index les recense et devient le seul à déclarer. Cet index peut lui même contenir jusqu'à cinquante mille entrées, ce qui autorise des architectures très larges. Un index d'index reste possible sur les très grands sites, configuration rare et parfaitement supportée. Le déclarer dans le fichier des robots, en plus de l'interface pour webmasters, permet aux autres moteurs de le trouver. C'est une ligne à ajouter et elle est souvent oubliée.
| Type de contenu | Découpage conseillé | Fréquence de régénération |
|---|---|---|
| Articles récents | Fichier dédié par année | À chaque publication |
| Articles archivés | Un fichier par année | Rare, sur modification |
| Pages fixes | Fichier unique | Sur modification |
| Fiches produit | Par famille au delà de mille | Quotidienne |
| Catégories | Fichier dédié | Hebdomadaire |
| Images | Fichier au format dédié | Hebdomadaire |
| Étiquettes | Fichier dédié si indexables | Hebdomadaire |
Taille, fréquence et champs
Les contraintes techniques sont peu nombreuses et régulièrement mal comprises, notamment sur les champs facultatifs dont l'utilité réelle est très inférieure à ce que l'on croit.
Les limites à respecter
Un fichier ne peut contenir plus de cinquante mille adresses et peser plus de cinquante mégaoctets non compressés. Ces limites sont larges et un découpage par type les respecte presque toujours. La compression est acceptée et recommandée sur les fichiers volumineux, elle divise le poids par dix sans inconvénient. Dépasser une limite invalide le fichier entier, pas seulement les lignes excédentaires. Cette règle explique pourquoi une croissance progressive du catalogue peut faire disparaître d'un coup un fichier entier des rapports.
Viser des fichiers plus petits
Rien n'oblige à approcher la limite et il y a tout intérêt à ne pas le faire. Des fichiers de mille à cinq mille adresses se régénèrent vite, se lisent à l'œil nu en cas de doute et rendent le diagnostic plus fin. La granularité utile est celle qui correspond aux décisions que l'on veut prendre. Un fichier trop gros redevient opaque, ce qui annule le bénéfice du découpage. Le repère pratique consiste à se demander si l'on serait prêt à ouvrir le fichier pour vérifier une adresse à la main.
La date de dernière modification
C'est le seul champ facultatif réellement utile, à condition d'être exact. Il doit refléter une modification substantielle du contenu, pas un recalcul automatique ni un changement de pied de page. Un site déclarant que toutes ses pages ont été modifiées ce matin fait perdre toute valeur à l'information, et le moteur cesse simplement d'en tenir compte. Mieux vaut ne pas renseigner ce champ que de le renseigner faussement. Beaucoup d'extensions le remplissent avec la date de dernière régénération, ce qui revient exactement à cela et mérite d'être vérifié après installation.
Les champs de priorité et de fréquence
Ces deux champs, hérités de la spécification d'origine, sont ignorés par les principaux moteurs depuis longtemps. Les renseigner ne fait aucun mal et ne sert à rien. Les discussions sur la valeur à leur donner sont donc sans objet, et le temps qu'on y consacre peut être employé plus utilement. Les omettre allège les fichiers de façon appréciable sur les gros volumes. Sur cinquante mille adresses, la différence se compte en mégaoctets, ce qui n'est pas négligeable pour un contenu sans effet.
La fréquence de régénération
Un fichier doit refléter l'état du site avec un délai raisonnable. Régénérer à chaque publication pour les contenus récents et quotidiennement pour les catalogues couvre les besoins courants. Régénérer toutes les heures un fichier de cinquante mille lignes coûte des ressources pour un bénéfice nul. Le bon rythme se déduit du rythme réel de publication, jamais d'une règle générale. Un site publiant deux articles par mois n'a aucune raison de régénérer quoi que ce soit chaque nuit.
La déclaration et le rappel
L'index se déclare une fois dans l'interface pour webmasters et se mentionne dans le fichier des robots. Il n'est pas nécessaire de le soumettre à nouveau après chaque mise à jour, le moteur revenant de lui même à un rythme adapté. Les soumissions manuelles répétées n'accélèrent rien. Elles gardent un intérêt ponctuel après une reprise importante de la structure. Dans ce cas, une soumission unique signale le changement et évite d'attendre le passage suivant.
Relevé effectué sur un site de plusieurs milliers d'adresses après découpage des sitemaps par type de contenu.
Lire les rapports et agir
Le découpage ne produit sa valeur qu'à condition d'aller regarder les résultats, ce qui demande de savoir ce que l'on cherche.
Le filtre par sitemap
Le rapport d'indexation propose un filtre par fichier déclaré, qui restreint l'ensemble des chiffres et des motifs d'exclusion au périmètre choisi. C'est la fonction qui justifie tout le travail de découpage. Elle est peu connue et elle transforme complètement l'exploitation de ces rapports. Un passage mensuel sur chaque fichier suffit à surveiller un site de taille moyenne. Noter les chiffres obtenus dans un tableau simple permet de suivre l'évolution sans dépendre de la profondeur d'historique de l'outil.
Les motifs d'exclusion
Les pages connues et non indexées sont classées par motif : exclue par une directive, page en double, explorée sans indexation, introuvable. Ces motifs n'appellent pas les mêmes réactions et certains sont parfaitement normaux. Une page en double dont la canonique est correctement déclarée ne pose aucun problème. Distinguer les motifs préoccupants des motifs attendus évite de courir après des faux problèmes. Les motifs à traiter en priorité sont ceux qui signalent une erreur technique, page introuvable ou erreur serveur, car ils indiquent que le sitemap déclare des adresses qui n'existent plus.
Le cas des pages explorées non indexées
C'est le motif le plus fréquent et le plus mal compris. Il signale que le moteur a vu la page et n'a pas jugé utile de l'indexer, appréciation qui porte sur la valeur du contenu et non sur un défaut technique. Aucune manipulation de sitemap ne corrige cela. La réponse relève de l'éditorial : enrichir, fusionner ou supprimer les pages concernées. Sur un catalogue, ce motif désigne souvent des fiches dont la description reprend celle du fournisseur, situation qui appelle un travail de réécriture plutôt qu'une intervention technique.
Comparer les volumes déclarés et découverts
Un écart important entre le nombre d'adresses déclarées dans un fichier et le nombre de pages connues du moteur signale un problème de génération. Un fichier annonçant huit cents produits alors que le catalogue en compte trois mille indique un filtre trop restrictif quelque part. Ce contrôle simple révèle des défauts de génération que personne ne surveille. Il se fait en comparant deux chiffres, une fois par trimestre. La cause la plus fréquente est un filtre sur le statut ou sur la visibilité qui exclut silencieusement une partie du catalogue.
Surveiller les erreurs de format
Les erreurs de lecture du fichier, adresses malformées, encodage incorrect, dépassement de taille, sont signalées explicitement. Elles apparaissent souvent après une mise à jour d'extension et passent inaperçues faute de consultation. Un contrôle après chaque intervention technique majeure suffit à les attraper. Une alerte automatique, lorsque l'outil le permet, dispense de la vigilance manuelle.
Documenter l'architecture retenue
Écrire quelles familles ont été séparées, pourquoi, et à quel rythme les fichiers sont régénérés évite qu'un successeur ne remette un fichier unique par simplicité. Cette note tient sur une demi page et elle protège un travail dont le bénéfice n'est pas visible à l'écran. Elle doit être relue lors de chaque refonte, moment où ce type de réglage disparaît le plus souvent. C'est la meilleure garantie de ne pas refaire le même chantier dans deux ans. Elle se relit également après chaque changement d'extension de référencement, ces outils reprenant généralement la main sur la génération du fichier et écrasant le découpage retenu sans aucun avertissement.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.