Un projet web dépend d'un interpréteur dans une version précise, d'un serveur de base de données dans une autre, de quelques extensions et parfois d'un outil de traitement d'images. Installer tout cela sur un poste de travail prend une demi journée et produit une configuration légèrement différente de celle du serveur, ce qui suffit à faire apparaître des bogues impossibles à reproduire. Le problème s'aggrave dès qu'une seconde personne rejoint le projet, ou qu'un ancien site doit être repris trois ans plus tard avec une version d'interpréteur que le poste actuel ne propose plus. Décrire l'environnement dans un fichier versionné avec le code résout ces trois situations, pour un coût d'apprentissage qui se compte en heures. Nous décrivons ici ce que cette approche apporte réellement à un projet web de taille modeste, ce qu'elle ne règle pas, comment composer un environnement complet et comment l'adopter sans bouleverser toute une organisation d'un coup.
Le problème que cela résout réellement
La conteneurisation est présentée de tant de façons qu'il est utile de préciser ce qu'elle apporte à un projet web de taille modeste. Ses principes fondamentaux sont exposés dans notre article sur la définition de Docker.
Le premier apport est la reproductibilité. Un fichier décrit les services nécessaires, leurs versions et leur configuration. N'importe qui disposant de ce fichier obtient exactement le même environnement, sur n'importe quel système. La phrase qui commence par cela fonctionne sur ma machine perd son objet, puisque toutes les machines exécutent la même chose. Ce seul bénéfice justifie l'apprentissage sur un projet impliquant plus d'une personne. Il vaut également pour une personne seule travaillant sur plusieurs postes, situation courante entre un ordinateur de bureau et un portable. La description de l'environnement voyage avec le code, sans manipulation supplémentaire.
Le deuxième apport est l'isolation entre projets. Un site nécessitant une ancienne version d'interpréteur cohabite sans difficulté avec un projet récent, chacun disposant de son propre environnement. Sur un poste de travail traditionnel, cette cohabitation impose des outils de gestion de versions et des manipulations fastidieuses. Avec des conteneurs, il suffit de démarrer le projet concerné. Pour une agence gérant une vingtaine de sites d'âges différents, ce point est décisif. Il supprime aussi une catégorie entière d'incidents : la mise à jour d'un outil système pour les besoins d'un projet, qui casse silencieusement un autre projet. Chaque environnement étant indépendant, aucune modification ne déborde sur les voisins.
Le troisième apport est la vitesse de démarrage d'un projet. Reprendre un site après deux ans d'interruption demande normalement de reconstituer l'environnement, exercice long et incertain. Avec un environnement décrit, la reprise prend le temps de télécharger les images, soit quelques minutes. Ce gain se manifeste précisément au moment où l'on en a le plus besoin, lors d'une intervention urgente sur un site ancien. Il change également la façon dont une agence répond à une demande : accepter une intervention ponctuelle sur un site de cinq ans devient possible, alors que le coût de remontage de l'environnement la rendait auparavant non rentable.
Le quatrième apport, moins évident, est documentaire. Le fichier de description constitue la documentation exacte et à jour de ce dont le projet a besoin. Il ne peut pas se périmer, puisqu'il est ce qui fait fonctionner l'environnement. Cette documentation exécutable vaut mieux que n'importe quelle page de wiki, invariablement obsolète après six mois. Elle répond à des questions que personne ne pense à documenter : quelle extension d'interpréteur est requise, quelle version de base de données, quel réglage particulier du serveur web. Ces informations manquantes constituent l'essentiel des difficultés lors d'une reprise.
Ce que cela ne résout pas
Il faut être clair sur les limites, car les attentes excessives conduisent à des déceptions et à l'abandon de l'outil.
La conteneurisation ne rend pas le développement plus rapide en soi. Sur certains systèmes, l'accès aux fichiers depuis un conteneur est notablement plus lent qu'un accès direct, ce qui ralentit les projets comportant beaucoup de fichiers. Des mécanismes de synchronisation existent pour atténuer ce point et ils ajoutent de la complexité. Sur un projet léger, la différence est imperceptible. Sur une installation lourde, elle se remarque et demande un réglage. Les solutions habituelles consistent à exclure du partage les dossiers de dépendances, qui n'ont pas besoin d'être visibles depuis le poste, ou à utiliser un mécanisme de synchronisation différée. Ces réglages sont documentés et ils ajoutent une couche de complexité qu'il faut assumer.
Elle ne dispense pas de comprendre les services utilisés. Savoir configurer un serveur web, régler un interpréteur ou diagnostiquer une base de données reste nécessaire. Le conteneur déplace l'endroit où ces réglages s'écrivent, il ne les supprime pas. Un développeur qui ne comprend pas ce qu'il configure obtiendra les mêmes difficultés, avec une couche supplémentaire à traverser. Le diagnostic demande d'ailleurs un réflexe nouveau : entrer dans le conteneur concerné pour observer ce qui s'y passe, plutôt que de regarder son propre système. Cette habitude se prend en quelques jours.
Elle ne garantit pas l'identité avec la production, sauf si la production utilise la même description. Un environnement local conteneurisé et un hébergement mutualisé classique restent différents, ne serait-ce que par les versions et les modules disponibles. Le rapprochement s'obtient en alignant volontairement les versions déclarées sur celles de l'hébergement, ce qui demande de les connaître. C'est un travail utile et il n'est pas automatique. La première étape consiste à relever, sur l'hébergement de production, la version exacte de l'interpréteur, celle de la base de données et la liste des extensions actives. Ces informations s'obtiennent en quelques minutes et elles orientent toute la description de l'environnement.
Elle n'est pas gratuite en ressources. Chaque projet démarré consomme de la mémoire et du processeur, et faire tourner cinq projets simultanément sur un poste modeste devient inconfortable. La discipline consiste à n'avoir qu'un projet actif à la fois, ce qui est de toute façon préférable pour la concentration. Un poste disposant de seize gigaoctets de mémoire convient largement à un usage courant. En dessous de huit, l'expérience devient inconfortable dès que deux projets tournent simultanément. Sur les systèmes qui exécutent les conteneurs dans une machine virtuelle intermédiaire, il faut aussi penser à ajuster la mémoire allouée à cette machine, réglage souvent laissé à une valeur trop basse.
| Situation | Sans conteneur | Avec conteneur | Gain |
|---|---|---|---|
| Arrivée d'un développeur | Une demi journée | Quinze minutes | Très élevé |
| Reprise d'un site ancien | Une journée, incertain | Quinze minutes | Très élevé |
| Projets de versions différentes | Manipulations fastidieuses | Immédiat | Élevé |
| Vitesse d'exécution locale | Référence | Égale ou inférieure | Négatif possible |
| Similarité avec la production | Faible | Selon la configuration | Variable |
| Consommation du poste | Faible | Notable | Négatif |
Composer un environnement de projet web
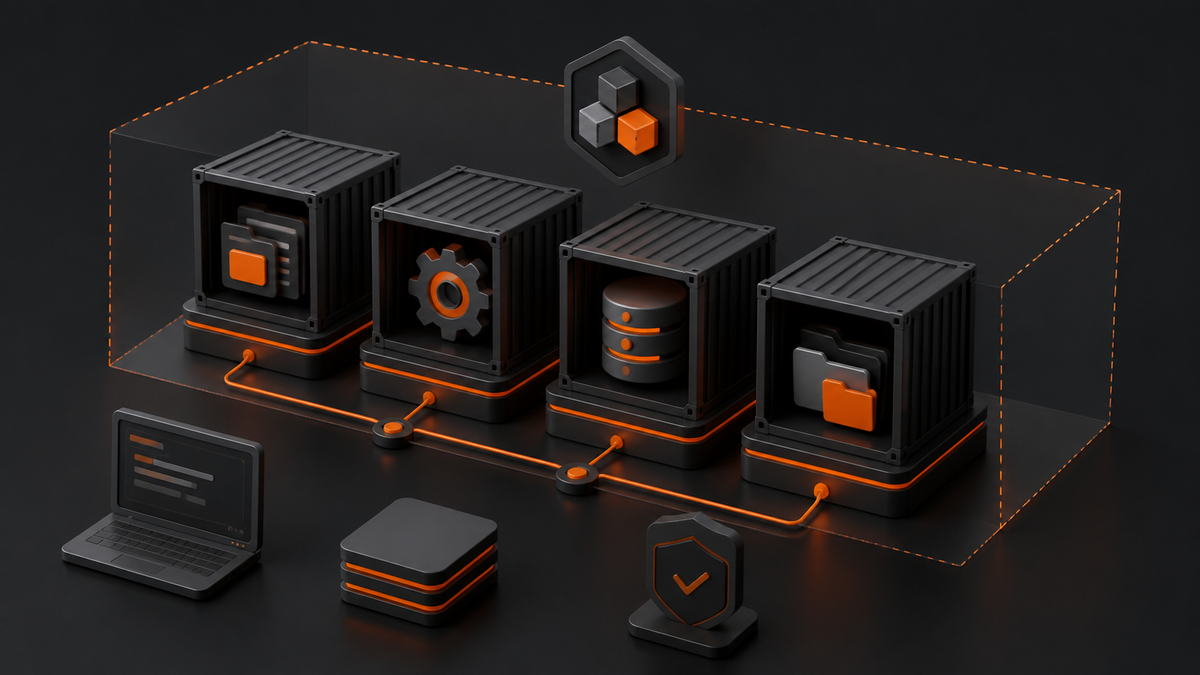
Un site classique demande trois services, décrits dans un fichier unique placé à la racine du dépôt.
Le premier service exécute le code applicatif, avec la version d'interpréteur souhaitée et les extensions nécessaires. Il vaut mieux partir d'une image officielle et y ajouter ce qui manque plutôt que de construire depuis zéro. La version doit être fixée explicitement, jamais laissée à la valeur la plus récente, faute de quoi l'environnement changera sans prévenir lors d'une reconstruction. Les extensions nécessaires se déclarent explicitement elles aussi, ce qui produit au passage la liste exacte des dépendances du projet. Cette liste est presque toujours plus courte que ce que le poste de travail avait accumulé au fil des années.
Le deuxième service fait tourner le serveur web, qui reçoit les requêtes et transmet celles qui concernent l'application. Sa configuration est un fichier monté depuis le dépôt, ce qui permet de la versionner et de la faire évoluer avec le projet. Aligner cette configuration sur celle de l'hébergement de production constitue le meilleur moyen d'éviter les mauvaises surprises au déploiement. Les règles de réécriture d'adresses, les limites de taille de téléversement et les délais d'exécution sont les trois réglages qui diffèrent le plus souvent. Les inscrire dans le fichier versionné leur donne le même statut que le code.
Le troisième service fournit la base de données, avec un volume persistant pour que les données survivent aux redémarrages. Un jeu de données de démarrage, placé dans un dossier prévu à cet effet, permet à un nouvel arrivant d'obtenir un site fonctionnel dès le premier lancement. Cette attention fait une différence considérable sur l'expérience d'accueil. Le jeu de données doit être anonymisé lorsqu'il provient d'une base réelle, les données personnelles de clients n'ayant rien à faire sur un poste de développement. Un extrait réduit, avec quelques dizaines d'enregistrements représentatifs, suffit largement et démarre bien plus vite.
Deux services optionnels méritent d'être ajoutés selon les projets : un serveur de courriel de test, qui capture les messages sortants et les affiche dans une interface, et un cache en mémoire lorsque l'application en utilise un. Le premier évite d'envoyer des courriels réels depuis un environnement de développement, incident classique et embarrassant lorsqu'il touche une base de clients importée. Il présente un second avantage : consulter le rendu exact des courriels transactionnels sans avoir à les recevoir sur une vraie boîte. Cette facilité change la façon de travailler les gabarits de messages.
Le code source doit être monté depuis le poste de travail plutôt que copié dans l'image, afin que les modifications soient prises en compte immédiatement. Les commandes courantes pour manipuler ces services sont recensées dans notre article sur les commandes Docker essentielles. Une dizaine d'entre elles couvrent l'usage quotidien : démarrer, arrêter, consulter les journaux, entrer dans un conteneur et reconstruire une image. Les mémoriser demande deux ou trois jours d'usage régulier. Un fichier de raccourcis placé dans le dépôt évite d'ailleurs de les retenir toutes.
Durées observées sur des projets web de taille moyenne, depuis le clonage du dépôt jusqu'à un site consultable.
Les pratiques qui rendent l'ensemble utilisable
La différence entre un environnement conteneurisé agréable et un environnement pénible tient à quelques détails d'organisation.
Le premier est la présence d'un fichier de démarrage documenté. Un nouvel arrivant doit pouvoir lancer le projet avec une seule commande, décrite dans les premières lignes du fichier de présentation du dépôt. Toute étape supplémentaire, toute variable à renseigner manuellement, toute manipulation non documentée réduit la valeur du dispositif. L'objectif est qu'un développeur productif le soit dans l'heure. Tester cette promesse avec une personne extérieure au projet est le seul moyen de la vérifier, celui qui a écrit la procédure ayant toujours des étapes implicites en tête. Ce test vaut la peine d'être fait une fois.
Le deuxième est la séparation entre configuration et secrets. Les identifiants de base de données locale peuvent figurer dans le fichier versionné, puisqu'ils ne servent qu'en développement. Les clés d'interface externes, en revanche, doivent venir d'un fichier local non versionné, dont un exemple est fourni. Cette séparation évite de publier des identifiants dans un dépôt, incident fréquent et coûteux, d'autant que l'historique conserve la trace d'une clé même après sa suppression. Le fichier d'exemple, versionné, liste les variables attendues avec des valeurs factices. Il sert à la fois de documentation et de gabarit.
Le troisième est la fixation des versions. Une image déclarée sans version précise change lors de chaque reconstruction, ce qui fait apparaître des dysfonctionnements sans rapport avec le travail en cours. Fixer une version majeure et mineure constitue le bon équilibre entre stabilité et réception des correctifs. Cette discipline se paie le jour où une reconstruction, six mois plus tard, produit exactement le même environnement. Sur les projets les plus sensibles, il est possible d'aller plus loin en figeant l'empreinte exacte de l'image, ce qui garantit une reproductibilité absolue au prix d'une mise à jour manuelle des correctifs de sécurité.
Le quatrième est le nettoyage régulier. Les images, conteneurs arrêtés et volumes orphelins occupent rapidement plusieurs dizaines de gigaoctets. Une commande de nettoyage lancée mensuellement évite de saturer le disque. Ce point est la cause la plus fréquente de frustration chez les nouveaux utilisateurs, qui découvrent un disque plein sans comprendre pourquoi. Il faut manier ces commandes de nettoyage avec précaution, certaines variantes supprimant les volumes et donc les bases de données locales. Lire ce que la commande annonce avant de confirmer évite de perdre un jeu de données de travail.
Le cinquième est la cohérence avec l'intégration continue. Le même environnement peut servir à exécuter les tests automatiques, ce qui garantit que ce qui passe localement passe aussi sur le serveur d'intégration. Cette réutilisation constitue l'un des bénéfices les plus concrets et elle demande simplement d'y penser dès la conception du fichier. Elle supprime la classe de problèmes où un test échoue uniquement sur le serveur d'intégration, pour des raisons de version, et où personne ne parvient à le reproduire localement.
Adopter progressivement
Basculer l'ensemble des projets d'une agence en une fois est irréaliste et inutile. La progression raisonnable commence par un projet neuf, où la conteneurisation ne remplace rien et s'ajoute simplement au démarrage.
Une fois l'équipe familiarisée, le deuxième candidat est le projet le plus pénible à installer, celui dont la reprise fait grimacer. Le gain y est immédiatement perceptible, ce qui emporte l'adhésion mieux que n'importe quelle démonstration. Ce projet demande généralement une demi journée de mise en place, l'essentiel du temps passant à identifier les dépendances réelles. Cette identification a une valeur en soi : elle révèle souvent des dépendances oubliées, des outils installés pour un besoin ponctuel et jamais retirés, ou des versions bien plus anciennes que ce que l'équipe croyait utiliser.
Les projets suivants bénéficient d'un modèle réutilisable, constitué à partir des deux premiers. Ce modèle, conservé dans un dépôt dédié, réduit la mise en place à une trentaine de minutes. Il doit rester simple, la tentation d'y ajouter tous les services imaginables produisant un environnement lourd et lent à démarrer. Mieux vaut un modèle minimal que chaque projet complète selon ses besoins réels. Les services optionnels peuvent d'ailleurs être déclarés dans un fichier séparé, activé uniquement quand on en a l'usage.
Les projets anciens, rarement touchés, ne justifient pas nécessairement l'effort. La règle pratique consiste à conteneuriser au moment de la première intervention plutôt qu'en anticipation. Le temps investi se récupère alors immédiatement, puisqu'il remplace la reconstitution manuelle de l'environnement qu'il aurait fallu faire de toute façon. Le surcoût réel se limite alors à l'écriture du fichier de description, soit une heure environ une fois le modèle disponible.
Une installation sur poste de travail reste nécessaire et elle est bien documentée pour les principaux systèmes, y compris sur les distributions serveur, comme le détaille notre article sur Docker sur Debian. Prévoir une demi journée de formation pour l'équipe, avec un projet réel comme support, constitue le meilleur investissement de tout le chantier. Les concepts se comprennent en manipulant, jamais en lisant.
Enfin, il faut accepter que certains projets ne s'y prêtent pas. Un site hébergé sur une offre mutualisée très contrainte, sans possibilité d'aligner les versions, tirera peu de bénéfice de l'exercice. Reconnaître ces cas évite de forcer un outil là où il n'apporte rien, ce qui reste la meilleure façon de préserver sa crédibilité auprès de l'équipe.
Aller jusqu'au déploiement, ou s'arrêter au développement
Une question revient dès que l'équipe maîtrise l'outil localement : faut-il déployer les mêmes conteneurs en production. La réponse dépend entièrement du type d'hébergement et du volume d'activité, et elle n'a rien d'évident.
Sur un hébergement mutualisé, la question ne se pose pas : rien ne permet d'y exécuter des conteneurs. L'environnement local reste alors un outil de développement, aligné autant que possible sur les versions de production, sans identité stricte. C'est le cas de la majorité des sites vitrines et de nombreux sites marchands de taille modeste, et il n'y a rien d'anormal à s'en tenir là.
Sur un serveur dédié ou un environnement en nuage, déployer les mêmes images supprime la dernière source d'écart entre développement et production. Le bénéfice est réel et il s'accompagne d'un coût de mise en place et d'exploitation qu'il ne faut pas sous-estimer : gestion des images, orchestration des redémarrages, persistance des données, sauvegardes des volumes. Ce chantier relève de l'administration système et il demande une compétence dédiée.
Un compromis répandu consiste à conteneuriser le développement et l'intégration continue, tout en déployant en production par les moyens habituels. Cette configuration capte l'essentiel du bénéfice, la reproductibilité entre les personnes et la fiabilité des tests, sans engager l'exploitation. Elle constitue le point d'arrivée raisonnable pour la plupart des agences.
Quelle que soit la décision, elle mérite d'être prise explicitement plutôt que subie. Une équipe qui conteneurise son développement sans avoir tranché la question de la production finit par entretenir deux façons de faire mal articulées, ce qui produit exactement les écarts que l'outil devait supprimer.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.