Limiter le nombre d'essais de connexion est une nécessité sur tout formulaire accessible publiquement. La façon la plus immédiate d'y parvenir consiste à enregistrer chaque échec dans une table, puis à compter les lignes récentes avant d'autoriser une nouvelle tentative. Cette approche fonctionne et elle transforme le formulaire en levier : chaque requête d'un attaquant provoque une écriture en base, ce qui permet de saturer le serveur avec un effort dérisoire. Plusieurs stockages alternatifs existent, chacun avec ses compromis, et le choix dépend surtout de l'architecture d'hébergement plutôt que d'une préférence technique.
Pourquoi éviter la base
Le raisonnement mérite d'être posé, car la base reste le réflexe par défaut et elle n'est pas absurde dans tous les contextes. Le problème tient à la nature de la donnée manipulée : un compteur d'échecs est éphémère, sans valeur historique au delà de quelques minutes, et sollicité précisément au moment où le service est attaqué. Ces trois caractéristiques désignent mal une base relationnelle, dont les garanties de durabilité coûtent cher et ne servent à rien ici. La logique est la même que celle exposée dans notre article sur la manière de limiter le débit d'une API pour éviter les abus.
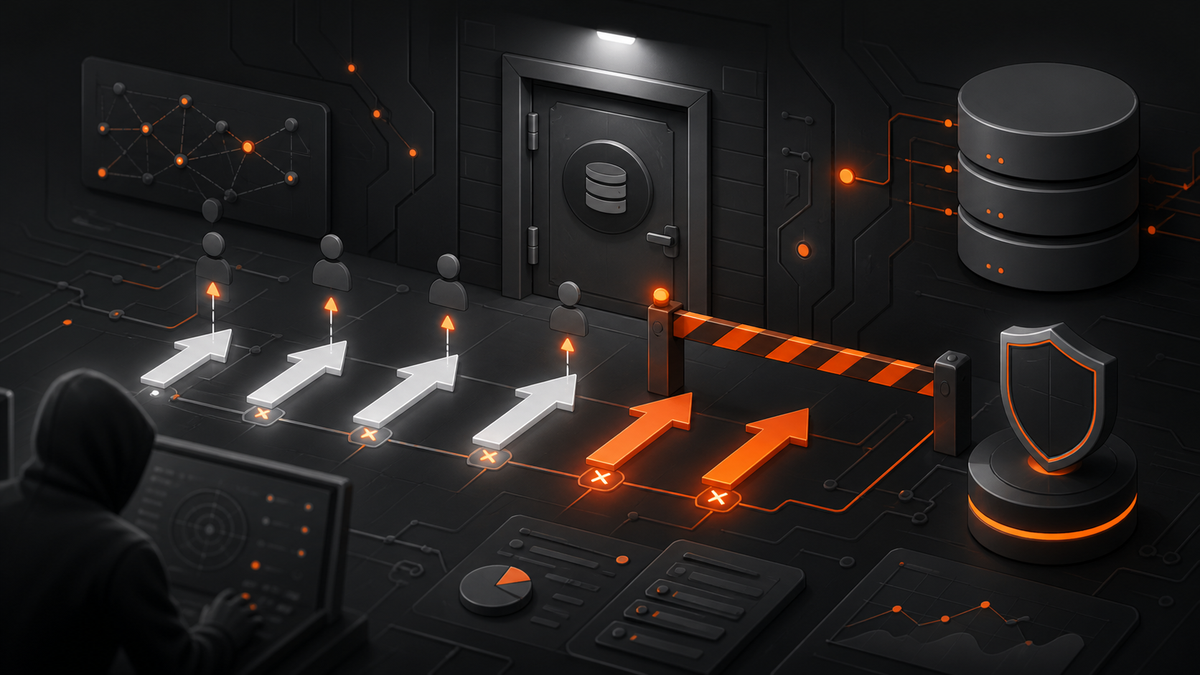
Chaque écriture en base implique une transaction, un journal d'écriture, potentiellement un verrou sur une table et une synchronisation sur disque. Ce coût, négligeable sur quelques connexions par minute, devient significatif sous une attaque distribuée produisant des centaines de tentatives par seconde. Le formulaire de connexion se transforme alors en point d'entrée privilégié pour épuiser les ressources, sans même chercher à deviner un mot de passe. Le paradoxe est complet : la mesure censée protéger le formulaire devient elle même le vecteur de l'attaque, et la désactiver améliorerait la résistance à la saturation tout en ouvrant la porte au devinage. Sortir de ce dilemme suppose simplement de changer de support de stockage.
La table concernée grossit par ailleurs rapidement et personne ne pense à la purger. Il n'est pas rare de trouver, sur un site ancien, une table de tentatives comptant plusieurs millions de lignes et pesant plus que le contenu du site. Les sauvegardes s'alourdissent, les restaurations ralentissent, et l'information conservée n'a aucune valeur passé quelques heures. Certaines équipes conservent ces lignes en pensant pouvoir mener une analyse a posteriori, analyse qui n'est en pratique jamais faite. Les journaux du serveur remplissent bien mieux ce rôle, avec un coût nul pour l'application.
Reste un argument en faveur de la base, qui a son poids : elle est disponible partout, sur tous les hébergements, sans configuration particulière. Sur un site à faible trafic, hébergé en mutualisé, sans mémoire partagée accessible, elle constitue une solution acceptable à condition de prévoir une purge automatique. L'important est de choisir en connaissance de cause plutôt que par défaut. Un site recevant quelques dizaines de connexions par jour ne rencontrera jamais le problème de charge décrit plus haut. La question devient sérieuse dès que le formulaire est visible depuis l'extérieur et que le site présente un intérêt quelconque pour un attaquant.
Le stockage en mémoire partagée
C'est la solution la plus adaptée à la nature de la donnée. Un serveur de cache en mémoire, installé sur la même machine ou sur le réseau local, offre des opérations d'incrémentation atomiques avec expiration automatique. Un compteur créé avec une durée de vie de quinze minutes disparaît tout seul, ce qui supprime entièrement la question de la purge. Cette expiration native est probablement l'argument le plus décisif, car elle élimine la seule tâche de maintenance que les autres solutions imposent.
Le fonctionnement tient en trois opérations. À chaque échec, on incrémente une clé construite à partir de l'identifiant et de l'adresse réseau, en fixant une expiration si la clé n'existait pas. Avant chaque tentative, on lit la valeur et on refuse au delà du seuil. À la connexion réussie, on supprime la clé. L'ensemble tient en une vingtaine de lignes et ne touche jamais le disque. La lecture et l'écriture se comptent en microsecondes, ce qui rend la vérification négligeable même sur un formulaire très sollicité.
L'atomicité de l'incrémentation est le point qui rend cette approche fiable. Deux requêtes simultanées ne peuvent pas lire la même valeur et écrire toutes deux la même incrémentation, comportement qu'une implantation naïve en fichier produirait. Cette garantie est fournie nativement par les serveurs de cache courants et elle évite d'avoir à gérer soi même un verrou. Le détail compte : une protection qui perd un échec sur trois sous charge ne protège plus au moment où elle devrait le faire.
La limite tient à la disponibilité de ce service. Beaucoup d'hébergements mutualisés ne le proposent pas, et l'installer suppose un accès au serveur. Sur un serveur dédié ou virtuel, c'est en revanche l'affaire de quelques minutes, et le service rendra d'autres services par la suite. Il faut aussi prévoir un comportement dégradé si le cache devient indisponible, en refusant de bloquer plutôt qu'en bloquant tout le monde. Ce choix est discutable et il correspond à l'usage établi : une panne de l'infrastructure de cache ne doit pas empêcher les utilisateurs légitimes de se connecter. La surveillance de la disponibilité du service devient alors une exigence à part entière.
| Stockage | Atomicité | Purge | Disponibilité |
|---|---|---|---|
| Base de données | Oui | À prévoir | Partout |
| Serveur de cache mémoire | Native | Automatique | Serveur dédié |
| Cache d'objets applicatif | Variable | Automatique | Selon la configuration |
| Fichiers avec verrou | À gérer | À prévoir | Partout |
| Mémoire du processus | Oui | Automatique | Un seul processus |
| Filtrage au niveau serveur | Native | Automatique | Accès administrateur |
Le stockage en fichiers
Sur un hébergement sans mémoire partagée, les fichiers constituent la solution de repli. Elle est parfaitement viable à condition de traiter correctement la question de la concurrence, qui est le point où les implantations maison échouent le plus souvent. Le défaut ne se voit pas en développement, où les requêtes arrivent une par une, et se révèle exactement au moment de l'attaque.
Le principe consiste à écrire un fichier par clé, dans un répertoire dédié hors de la racine web, contenant le compteur et l'horodatage. La lecture puis l'écriture doivent être encadrées par un verrou exclusif sur le fichier, faute de quoi deux requêtes simultanées se contredisent. Le langage fournit les fonctions nécessaires et leur usage correct demande d'ouvrir le fichier en lecture et écriture avant de poser le verrou. Ouvrir en écriture seule tronque le fichier avant même que le verrou ne soit posé, erreur classique qui vide le compteur à chaque tentative.
Le nom du fichier ne doit jamais être construit directement à partir d'une donnée fournie par le visiteur. Un identifiant contenant des séparateurs de chemin permettrait d'écrire ailleurs sur le disque. Hacher la clé avant de l'utiliser comme nom de fichier règle définitivement la question et produit au passage des noms de longueur constante. Cette précaution vaut pour toute écriture de fichier construite depuis une entrée utilisateur. Elle ne coûte qu'un appel de fonction et elle ferme une catégorie entière de failles.
La purge doit être prévue explicitement puisque rien ne l'assure. Une suppression des fichiers plus anciens qu'une heure, déclenchée aléatoirement sur une fraction des requêtes ou par une tâche planifiée, suffit. Sans elle, le répertoire accumule des dizaines de milliers de fichiers minuscules qui ralentissent le système de fichiers et compliquent les sauvegardes. Les questions de permissions sur ce répertoire méritent également attention, sujet que nous abordons dans notre article sur le fichier htaccess et son rôle en sécurité.
Répartition constatée lors de revues techniques de sites disposant d'une limitation des tentatives de connexion.
Le cache d'objets applicatif
La plupart des cadres applicatifs et des systèmes de gestion de contenu exposent une abstraction de cache, qui utilise selon la configuration la mémoire partagée, un fichier ou une table. Passer par cette abstraction plutôt que par une implantation directe présente l'avantage de s'adapter automatiquement à l'hébergement. Le même code fonctionne alors sur un mutualisé modeste et sur une infrastructure disposant d'un serveur de cache dédié, sans modification.
Cette commodité a un revers qu'il faut connaître : le comportement varie selon l'implantation retenue, et l'atomicité n'est pas garantie par toutes. Un cache adossé à des fichiers sans verrou perdra des incrémentations sous charge, ce qui affaiblit la protection au moment précis où elle serait utile. Vérifier quelle implantation est active en production fait donc partie du travail. L'information est en général accessible par une fonction de diagnostic du cadre applicatif, et elle mérite d'être consignée dans la documentation du projet.
Un second piège concerne la persistance. Certains caches sont non persistants et se vident au redémarrage du processus, ce qui remet tous les compteurs à zéro. Sur un hébergement où les processus tournent quelques minutes, la protection devient illusoire. Ce comportement se vérifie facilement en observant si le compteur survit à un redémarrage du service. Sur une infrastructure comportant plusieurs serveurs applicatifs, il faut également vérifier que le compteur est partagé entre eux, faute de quoi le seuil réel est multiplié par le nombre de machines.
Malgré ces réserves, l'abstraction reste le bon choix pour du code destiné à être déployé sur des environnements variés, extension distribuée ou modèle de projet. Elle permet d'écrire une fois et de laisser l'administrateur choisir son moteur. Il vaut mieux documenter clairement quel moteur est recommandé, plutôt que de laisser croire que tous se valent. Une mention explicite dans la documentation d'installation évite des déploiements dont la protection est nominale.
Le filtrage en amont de l'application
La solution la plus efficace consiste à ne jamais laisser la requête atteindre l'application. Un module de limitation au niveau du serveur web, ou un outil analysant les journaux pour bloquer les adresses fautives au niveau du pare feu, traite le problème sans consommer de ressources applicatives.
Les serveurs web courants proposent des modules de limitation de débit configurables par emplacement. Appliquer une limite stricte sur la seule adresse du formulaire de connexion, en laissant le reste du site libre, demande quelques lignes de configuration. Cette approche coûte pratiquement rien en ressources et elle s'applique avant tout traitement, ce qui la rend particulièrement adaptée aux attaques volumétriques. Le réglage demande un peu de tâtonnement pour ne pas gêner un utilisateur qui recharge la page, et il se stabilise rapidement à l'observation.
Les outils de bannissement analysant les journaux vont plus loin en bloquant l'adresse au niveau réseau pour une durée déterminée. Ils supposent que l'application journalise correctement les échecs, avec un format reconnaissable, ce qui crée une dépendance à surveiller lors des mises à jour. Leur efficacité contre les attaques distribuées reste limitée, chaque adresse ne produisant que quelques tentatives. Ils restent très efficaces contre les outils automatisés simples, qui constituent l'essentiel du volume observé sur un site ordinaire.
La limite commune à ces approches est qu'elles raisonnent sur l'adresse réseau et ignorent l'identifiant visé. Une attaque ciblant un compte précis depuis mille adresses différentes passe entre les mailles. La protection au niveau serveur et la protection applicative sont donc complémentaires plutôt qu'alternatives, la première traitant le volume et la seconde traitant le ciblage. Les déployer ensemble ne demande aucun arbitrage, chacune agissant à un niveau différent de la pile.
Les pièges du comptage
Le choix du stockage réglé, restent les décisions qui déterminent si la protection est utile ou seulement gênante. Elles sont indépendantes de la technique retenue et méritent autant d'attention.
Compter uniquement par adresse réseau bloque des bureaux entiers, des établissements scolaires et des opérateurs mobiles partageant une sortie commune. Compter uniquement par identifiant offre à un tiers le moyen de verrouiller n'importe quel compte en échouant volontairement. La combinaison des deux, avec des seuils distincts, constitue le compromis établi : un seuil bas sur le couple identifiant et adresse, un seuil plus haut sur l'adresse seule. Un troisième compteur, portant sur l'identifiant seul avec un seuil élevé, complète utilement le dispositif face aux attaques distribuées visant un compte précis.
Le verrouillage franc doit être évité au profit d'un délai croissant entre les tentatives. Deux secondes après trois échecs, cinq après cinq, trente après dix : cette progression rend l'attaque automatisée impraticable sans jamais empêcher un utilisateur légitime de se reprendre. Elle évite surtout de donner à un tiers un pouvoir de nuisance sur les comptes d'autrui. Le confort pour l'utilisateur légitime est par ailleurs très supérieur, un délai de quelques secondes passant inaperçu là où un verrouillage impose un appel au support.
La réponse renvoyée doit rester identique quel que soit le motif du refus. Indiquer que le compte est temporairement bloqué confirme son existence, information que l'on cherchait à protéger. Un message unique et neutre, accompagné du code de retour approprié, préserve cette discrétion. Le délai avant nouvelle tentative peut en revanche être communiqué sans risque. Cette indication améliore nettement l'expérience sans rien révéler sur l'existence du compte visé.
La remise à zéro après connexion réussie est enfin indispensable et régulièrement oubliée. Sans elle, un utilisateur ayant tapé trois fois de travers avant de réussir garde son compteur pendant la durée de la fenêtre, et se retrouve bloqué à la connexion suivante. Ce comportement produit des signalements incompréhensibles pour le support. La ligne de suppression du compteur tient en un appel et elle règle définitivement le problème. La session ouverte ensuite mérite par ailleurs les précautions décrites dans notre article sur les sessions PHP, leur durée de vie et leur régénération.
Vérifier que la protection fonctionne
Une limitation jamais testée est une limitation dont on ignore l'état. Le contrôle demande dix minutes et il évite de découvrir un défaut au pire moment.
Le test de base consiste à échouer volontairement au delà du seuil et à vérifier que le refus intervient, puis que l'accès se rétablit après le délai prévu. Ce test doit être mené depuis un navigateur en fenêtre privée, pour éviter que des éléments de session ne faussent le résultat. Il doit aussi être refait après chaque mise à jour de l'environnement.
Le test de concurrence, plus révélateur, consiste à lancer plusieurs requêtes simultanées et à vérifier que le compteur reflète bien leur nombre. Un outil de test de charge simple suffit. C'est ce test qui met en évidence les problèmes d'atomicité, invisibles en usage séquentiel et déterminants sous attaque réelle.
La surveillance des journaux dans les semaines suivantes complète le contrôle. Observer le volume de refus permet d'ajuster les seuils au trafic réel : un seuil qui déclenche cent fois par jour sur un site à faible affluence est probablement trop bas. Ces réglages se stabilisent en général après quelques semaines d'observation.
Reste à documenter la configuration retenue, stockage employé, seuils, durées, comportement en cas d'indisponibilité du stockage. Cette note évite qu'une intervention ultérieure ne désactive la protection sans que personne ne s'en aperçoive. Elle est particulièrement utile lorsque la limitation repose sur plusieurs couches, serveur et application, dont l'interaction n'a rien d'évident pour un intervenant extérieur. Elle doit préciser laquelle des deux couches répond en premier et avec quel code, information sans laquelle un diagnostic conduit depuis les seuls journaux applicatifs aboutit systématiquement à une conclusion fausse.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.