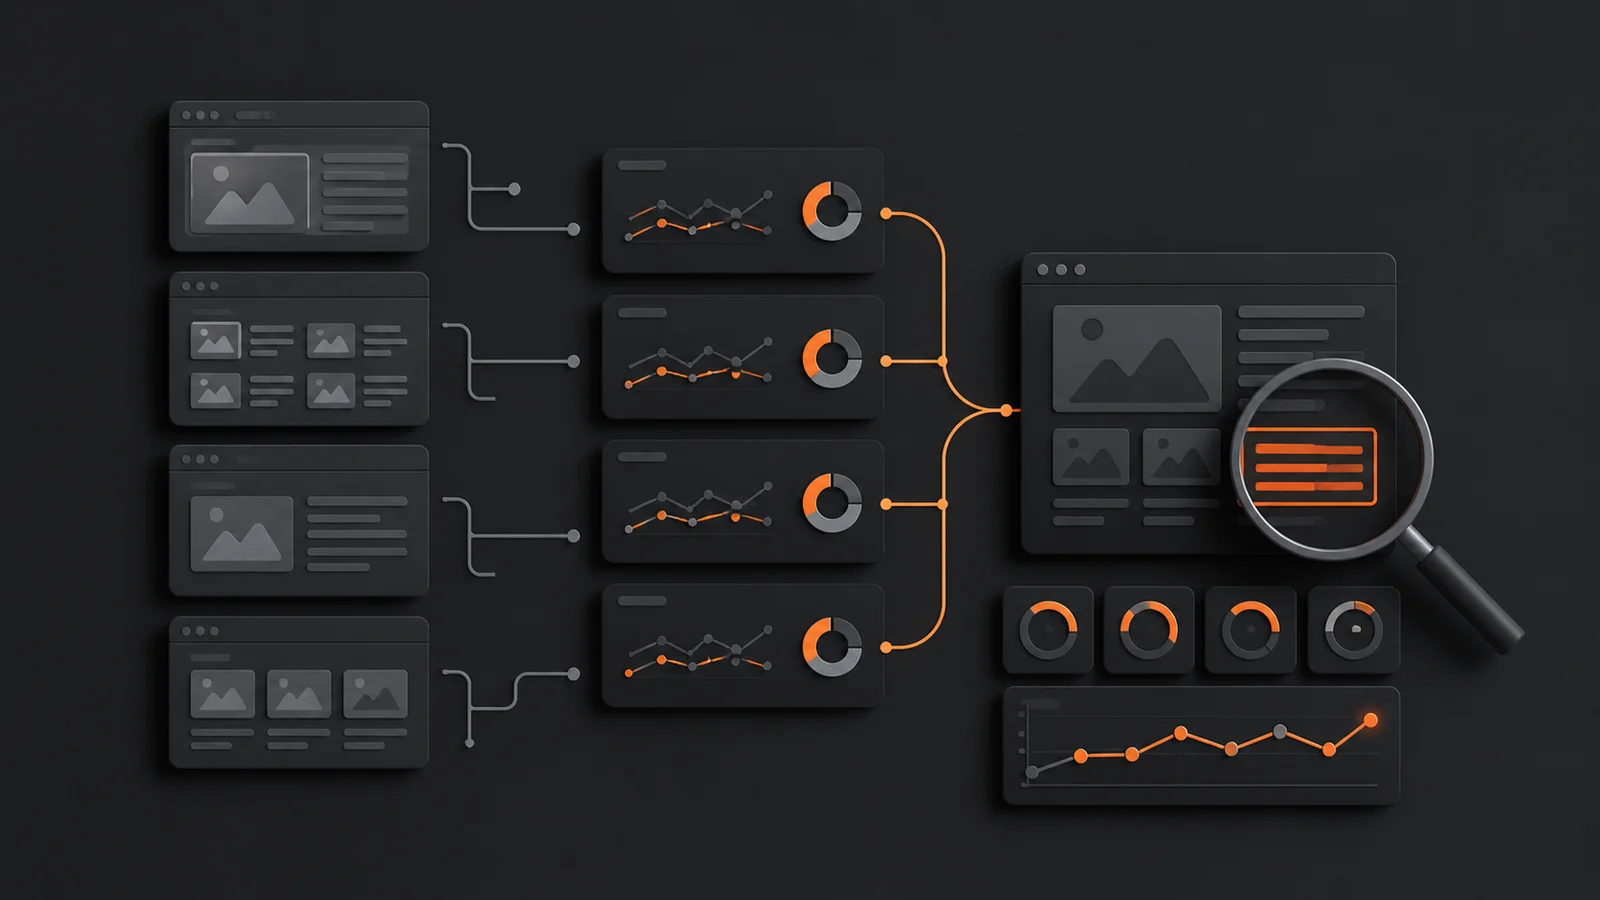
Un rapport de performance affichant un site partiellement conforme laisse son propriétaire devant une question sans réponse : par où commencer. Les recommandations générales, réduire les images, différer les scripts, alléger le code, s'appliquent partout et nulle part en particulier. La réalité est presque toujours plus concentrée : un ou deux gabarits de page dégradent les indicateurs, pendant que le reste du site se comporte correctement. Identifier ces gabarits transforme un chantier flou en intervention ciblée, et cette identification demande simplement de regrouper les mesures autrement que ne le font les outils par défaut.
Pourquoi la moyenne ne dit rien
Le raisonnement mérite d'être posé, car il détermine tout le reste de la méthode. Un site est composé de familles de pages construites par des gabarits différents, dont les caractéristiques techniques n'ont rien de commun. Les mélanger dans une même moyenne produit un chiffre qui ne correspond au comportement d'aucune page réelle. La définition et le fonctionnement de ces mesures sont rappelés dans notre article sur les Core Web Vitals dans la Google Search Console.
Des gabarits très différents
Une page d'accueil comporte un grand visuel, un diaporama et plusieurs blocs dynamiques. Une fiche produit charge une galerie, un module de zoom et des blocs de recommandations. Un article de blog est essentiellement du texte. Ces trois pages n'ont aucune raison d'obtenir des mesures comparables, et leur moyenne ne décrit rien. C'est pourtant ce chiffre unique que la plupart des tableaux de bord affichent en premier. Il donne une impression de synthèse qui décourage toute analyse plus fine, ce qui est exactement l'inverse du service rendu.
La pondération par le trafic
Les données de terrain agrègent les visites réelles, ce qui fait peser lourdement les pages les plus consultées. Un site dont quatre vingts pour cent du trafic va sur des articles de blog rapides affichera une moyenne satisfaisante, même si toutes ses fiches produit sont mauvaises. Le chiffre global est donc doublement trompeur : il masque le problème et il rassure. Sur un site marchand, ce sont précisément les pages qui convertissent qui méritent l'attention. Une fiche produit lente coûte des commandes, un article lent coûte quelques secondes de lecture.
L'effet des valeurs extrêmes
Les indicateurs de terrain sont exprimés en centiles plutôt qu'en moyennes, ce qui limite déjà l'effet des valeurs aberrantes. Cette précaution ne suffit pas lorsque les populations mélangées sont réellement distinctes. Un centile calculé sur deux populations très différentes décrit la moins bonne des deux si elle représente une part suffisante du trafic. Séparer les populations est la seule façon d'obtenir un chiffre interprétable. Cette règle vaut d'ailleurs pour toute analyse statistique et elle est régulièrement oubliée dès qu'un tableau de bord propose une valeur unique.
La différence entre laboratoire et terrain
Les tests menés depuis un outil en ligne mesurent une page dans des conditions simulées, ce qui donne un diagnostic détaillé et non représentatif. Les données de terrain agrègent les visites réelles, ce qui donne un chiffre représentatif et peu détaillé. Les deux sont nécessaires et à des moments différents : le terrain pour identifier le gabarit fautif, le laboratoire pour comprendre pourquoi. Confondre les deux fait perdre beaucoup de temps. Une page notée excellente en laboratoire et dégradée sur le terrain n'a rien de contradictoire, les conditions mesurées n'étant pas les mêmes.
Le regroupement proposé par défaut
Les outils pour webmasters regroupent les adresses par similarité de comportement, ce qui produit des ensembles parfois pertinents et souvent trop larges. Ce regroupement est une aide et il ne remplace pas une segmentation par gabarit décidée par vous. Il constitue néanmoins un excellent point de départ, les groupes proposés recoupant souvent les familles réelles. Les examiner avant de construire sa propre segmentation fait gagner du temps. Ils donnent aussi une indication sur la façon dont le moteur perçoit la structure du site, information utile en elle même.
Ce que change une bonne segmentation
Constater que les fiches produit obtiennent un mauvais résultat sur un indicateur précis, alors que le reste du site est conforme, désigne immédiatement le gabarit à reprendre. L'intervention porte alors sur un seul fichier de gabarit et elle profite à des milliers de pages d'un coup. C'est le meilleur rapport possible entre effort et résultat sur ce type de sujet. Sans segmentation, le même travail se disperse sur des optimisations générales à effet marginal. La différence de résultat entre les deux approches se compte en semaines de travail.
Construire la segmentation
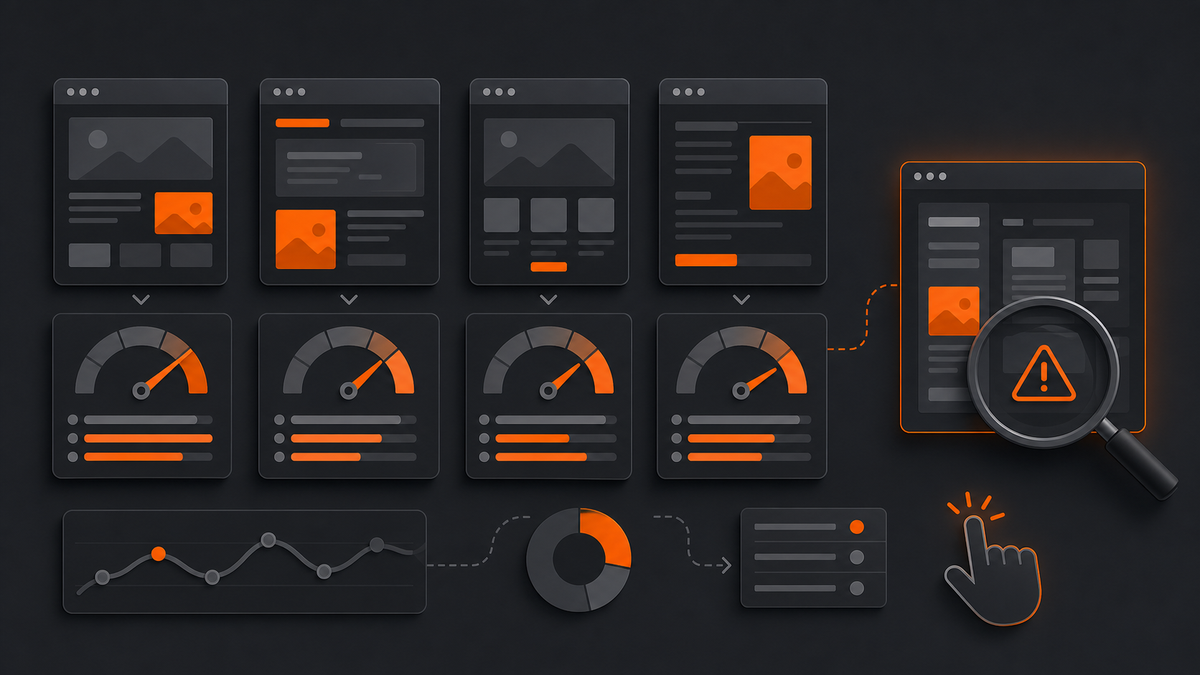
La méthode est simple et elle demande un peu de rigueur dans la définition des familles, qui doit correspondre à la réalité technique du site.
Lister les gabarits réels
Le point de départ consiste à énumérer les modèles de page effectivement employés : accueil, catégorie, fiche produit, article, page de contenu, panier, compte, résultats de recherche. Cette liste s'obtient en regardant les fichiers du thème plutôt qu'en devinant. Six à dix familles couvrent la quasi totalité des sites. Une liste plus longue signale généralement qu'on a confondu variations d'affichage et gabarits distincts. Deux pages employant le même fichier de gabarit appartiennent à la même famille, même si leur contenu diffère beaucoup.
Associer un motif d'adresse à chaque famille
Chaque gabarit doit pouvoir être reconnu à partir de l'adresse, par un segment de chemin ou un préfixe. Sur un site aux adresses bien structurées, cette association est immédiate. Sur un site aux adresses plates, elle demande d'exporter la liste des pages avec leur type depuis la base, puis de croiser. Ce croisement est un peu fastidieux et il ne se fait qu'une fois. Le tableau obtenu sert ensuite à toutes les analyses ultérieures, bien au delà de la question des indicateurs de performance.
Marquer le gabarit dans la mesure
La solution la plus propre consiste à transmettre le nom du gabarit à l'outil de mesure, comme une dimension personnalisée, au moment du chargement de la page. Le regroupement devient alors natif et il ne dépend plus d'aucun motif d'adresse. Cette mise en place demande quelques lignes dans le gabarit et elle transforme durablement la lisibilité des rapports. C'est l'investissement le plus rentable de tout le sujet. Il profite également à l'analyse d'audience, où la segmentation par gabarit est tout aussi éclairante.
Employer les données de terrain publiques
Un jeu de données public agrège les mesures réelles par origine et par page, pour les sites disposant d'un trafic suffisant. Il permet d'obtenir les valeurs par adresse, donc de les regrouper comme on le souhaite. Son accès demande un peu d'outillage et il donne la vision la plus fidèle disponible gratuitement. Sur les sites à faible trafic, les données par page manquent et seule l'origine est disponible. Dans ce cas, la mesure maison décrite plus bas devient la seule option praticable.
Compléter par une mesure maison
Une bibliothèque légère permet de mesurer les indicateurs dans le navigateur des visiteurs et de les envoyer vers son propre point de collecte, avec le gabarit en dimension. Cette approche fonctionne quel que soit le trafic et elle donne des données immédiatement segmentées. Elle demande de traiter la question des données personnelles, la mesure étant associée à une visite. Nous ne sommes pas juristes et ce point mérite un avis compétent selon la configuration retenue. Techniquement, une collecte sans identifiant de visiteur et sans adresse conservée réduit fortement le périmètre concerné.
Croiser avec le TTFB
Le temps de réponse du serveur, mesuré par gabarit, explique souvent une partie des écarts constatés sur les indicateurs d'affichage. Un gabarit lent à produire décale tout ce qui suit, sans que le problème soit lié au poids de la page. Cette mesure se mène séparément, comme nous le décrivons dans notre article sur la manière de mesurer le TTFB par gabarit de page.
| Gabarit | Cause fréquente de dégradation | Indicateur touché |
|---|---|---|
| Accueil | Grand visuel et diaporama | Affichage du contenu principal |
| Catégorie | Nombreuses vignettes sans dimensions | Stabilité visuelle |
| Fiche produit | Galerie et module de zoom | Réactivité aux interactions |
| Article | Blocs tiers et publicités | Stabilité visuelle |
| Panier | Calculs et appels serveur | Réactivité aux interactions |
| Recherche interne | Requête lente côté serveur | Temps de réponse |
| Page de contenu | Généralement conforme | Aucun |
Lire les écarts
Une fois les données regroupées, l'interprétation suit quelques règles simples qui évitent les fausses pistes.
Comparer chaque gabarit au seuil
La lecture utile compare chaque famille aux seuils de conformité plutôt qu'aux autres familles. Un gabarit meilleur que les autres mais sous le seuil reste à corriger. Cette comparaison au seuil, et non entre familles, évite de se satisfaire d'un classement interne flatteur. Les seuils étant les mêmes pour tout le monde, ils constituent la seule référence objective disponible. Elle donne aussi une liste de priorités immédiatement exploitable. Trier les gabarits par écart au seuil produit en trente secondes le plan d'intervention.
Pondérer par le trafic
Un gabarit très dégradé qui représente deux pour cent du trafic pèse moins qu'un gabarit légèrement dégradé qui en représente soixante. La priorisation doit croiser la gravité et le volume, ce qui se fait avec deux colonnes dans un tableau. Ce croisement conduit régulièrement à traiter en premier un gabarit qui n'était pas le plus mauvais. C'est la décision qui produit le plus de gain mesurable. Elle est aussi la plus facile à justifier auprès d'une direction, puisqu'elle s'exprime en volume de visites concernées.
Distinguer mobile et ordinateur
Les mesures diffèrent fortement entre les deux, au point qu'un gabarit conforme sur ordinateur peut être franchement mauvais sur mobile. Les deux populations doivent être séparées, faute de quoi les écarts se compensent et disparaissent. Sur la plupart des sites, le mobile est à la fois la population majoritaire et la plus dégradée. C'est donc par lui qu'il faut commencer. Traiter le mobile en premier améliore d'ailleurs presque toujours l'ordinateur au passage, l'inverse n'étant pas vrai.
Identifier l'indicateur dominant
Chaque gabarit dégrade en général un seul indicateur, ce qui oriente immédiatement le diagnostic. Un problème d'affichage du contenu principal désigne une ressource lourde ou un serveur lent. Un problème de stabilité visuelle désigne des éléments sans dimensions réservées. Un problème de réactivité désigne un traitement long en JavaScript. Cette correspondance entre indicateur et famille de causes réduit considérablement le champ des recherches. Le fonctionnement de ce premier indicateur est détaillé dans notre article sur le problème de LCP dans la Google Search Console.
Vérifier sur des pages réelles
Une fois le gabarit identifié, un test en laboratoire sur trois pages de cette famille donne le détail technique manquant. Ce test doit porter sur des pages représentatives et non sur la plus mauvaise, sous peine de traiter un cas particulier. La comparaison de trois pages du même gabarit confirme que le problème est structurel et non local. Ce contrôle prend dix minutes et il évite de partir dans la mauvaise direction. Il permet aussi de repérer les pages dont le contenu, plutôt que le gabarit, explique la dégradation.
Se méfier des faux coupables
Les outils de laboratoire proposent des recommandations classées par gain théorique, qui ne correspondent pas toujours au problème constaté sur le terrain. Un gain annoncé de deux secondes sur une ressource qui n'est jamais bloquante en usage réel ne produira rien. La confrontation entre le diagnostic de laboratoire et l'indicateur dégradé sur le terrain est ce qui permet de trier. C'est l'étape que la plupart des interventions sautent. Elle demande de résister à la tentation de suivre la liste de recommandations dans l'ordre où elle est présentée.
Proportion de pages dépassant les seuils sur au moins un indicateur, relevée par gabarit sur données de terrain mobiles.
Corriger et mesurer l'effet
Une correction de gabarit produit un effet sur des milliers de pages, ce qui rend la mesure du résultat particulièrement lisible.
Corriger dans le gabarit
Le travail doit porter sur le fichier de gabarit et non sur les pages individuelles, ce qui est tout l'intérêt de la démarche. Réserver les dimensions des images, retirer un module inutilisé, différer un script secondaire : ces interventions se font une fois et s'appliquent partout. Cette économie d'échelle est ce qui rend le sujet abordable sur un site volumineux. Corriger dix mille fiches produit une par une n'aurait évidemment aucun sens. Elle suppose évidemment que le gabarit soit unique et non dupliqué en plusieurs variantes. Sur un site où le même modèle a été copié quatre fois, la première tâche consiste à factoriser.
Traiter un gabarit à la fois
Corriger simultanément trois gabarits rend impossible d'attribuer une amélioration à une cause. Une intervention par famille, avec quelques semaines d'observation entre chacune, permet de mesurer et d'apprendre. Cette progression allonge le chantier et elle produit une connaissance réutilisable sur les projets suivants. Elle évite aussi de tout défaire lorsqu'une correction produit une régression. Consigner la date de chaque intervention permet ensuite de relire les courbes sans hésitation.
Attendre les données de terrain
Les indicateurs de terrain reposent sur une fenêtre glissante de plusieurs semaines, ce qui signifie qu'une correction met un mois à se refléter complètement. Conclure à un échec au bout de trois jours est la réaction la plus fréquente et la plus injustifiée. Ce délai doit être annoncé avant l'intervention, faute de quoi la pression s'exerce au mauvais moment et conduit à empiler des corrections dont plus personne ne mesure l'effet. Le laboratoire, lui, mesure immédiatement et sert de contrôle intermédiaire. Il confirme que la correction produit bien l'effet attendu, en attendant que le terrain le confirme sur données réelles.
Suivre par gabarit
Le suivi doit employer la même segmentation que le diagnostic, sinon l'amélioration d'une famille se dilue dans la moyenne générale. Un tableau à une ligne par gabarit, relevé mensuellement, montre la progression de chacune. Ce tableau est également le meilleur support pour rendre compte du travail. Conserver les relevés successifs permet de montrer la progression plutôt que le seul état courant. Il transforme une amélioration technique en résultat visible. Un graphique par gabarit communique nettement mieux qu'un rapport d'outil, y compris auprès de personnes non techniques.
Surveiller les régressions
Un gabarit corrigé peut se dégrader à nouveau après l'ajout d'un module, d'un script de mesure ou d'un bloc de recommandations. Une vérification après chaque évolution du gabarit concerné attrape ces retours en arrière. Ce contrôle prend cinq minutes en laboratoire et il évite de refaire le même travail six mois plus tard. Il mérite de figurer dans la liste de contrôle des mises en production. Une ligne suffit, rappelant de tester le gabarit modifié avant la livraison.
Documenter les causes trouvées
Une note listant, pour chaque gabarit, l'indicateur dégradé, la cause identifiée et la correction apportée constitue une connaissance directement réutilisable. Elle évite de refaire le diagnostic lors de la refonte suivante et elle accélère considérablement le travail sur les projets similaires. Cette note tient sur une page. Elle est ce qui distingue une intervention ponctuelle d'une compétence qui se construit. Les mêmes causes reviennent d'un projet à l'autre, ce qui rend cette accumulation particulièrement rentable. Elle gagne à mentionner le gabarit concerné et la correction retenue, sans le détail de la mise en oeuvre, ce qui la rend réutilisable sur un projet dont le code n'a rien de commun.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.