Il n'est pas rare qu'une page porte deux directives d'indexation qui se contredisent : une balise autorisant l'indexation dans le code source, un en tête HTTP l'interdisant, et parfois une troisième valeur ajoutée par une extension de référencement. La question de savoir laquelle s'applique a une réponse simple et une mise en pratique nettement moins évidente, car les sources de ces directives sont nombreuses et se superposent sans que personne n'en tienne le compte. Comprendre la règle de résolution et savoir où chercher permet de diagnostiquer en dix minutes des situations qui traînent parfois depuis des mois.
La règle de résolution
La logique appliquée par les moteurs est cohérente et elle se résume en une phrase : en cas de conflit, la directive la plus restrictive l'emporte. Ce principe protège contre les erreurs de configuration en penchant du côté de la prudence, ce qui est le comportement souhaitable de leur point de vue et parfois désagréable du vôtre. Une page que vous croyez indexable peut être exclue par une directive oubliée quelque part, sans qu'aucun message ne le signale. Les conséquences de ce mécanisme sur la visibilité sont développées dans notre article sur la balise noindex et son utilité en SEO.
Le principe du plus restrictif
Entre une directive autorisant l'indexation et une autre l'interdisant, l'interdiction gagne systématiquement, quel que soit l'ordre dans lequel elles apparaissent dans le document. Il en va de même entre une autorisation de suivre les liens et une interdiction, ou entre une absence de limite de longueur d'extrait et une limite. Cette règle vaut aussi bien entre deux balises du document qu'entre une balise et un en tête HTTP. Elle est simple et elle explique pourquoi ajouter une directive positive ne corrige jamais une directive négative posée ailleurs. La seule correction consiste à retirer la directive restrictive à sa source. C'est une règle contre intuitive pour beaucoup, qui ajoutent une directive positive en espérant annuler la précédente et constatent que rien ne change.
La combinaison des directives distinctes
Deux directives portant sur des aspects différents ne se contredisent pas et s'additionnent. Une balise interdisant l'indexation et une autre autorisant le suivi des liens décrivent deux comportements compatibles, qui s'appliquent tous les deux. C'est d'ailleurs une combinaison courante et parfaitement légitime sur les pages paginées. La notion de contradiction ne concerne donc que les directives portant sur le même aspect, ce qui restreint le nombre de cas réellement problématiques. Il faut donc lire chaque directive comme une déclaration indépendante sur un comportement précis, et non comme un réglage global à valeur unique.
L'en tête HTTP et la balise
Les deux mécanismes ont exactement la même valeur et se combinent selon la règle précédente. L'en tête présente l'avantage de couvrir les fichiers non HTML, documents et images notamment, pour lesquels aucune balise n'est possible. Il présente l'inconvénient d'être invisible sans outil, ce qui le rend facile à oublier lors d'un diagnostic. Beaucoup d'heures se perdent à chercher une balise inexistante alors que la directive vient d'une règle de configuration du serveur. Prendre l'habitude de regarder les en têtes en premier réduit considérablement ce risque.
Les directives par moteur
Une directive peut cibler un robot précis en nommant son agent plutôt qu'en s'adressant à tous. Un robot appliquant alors la directive qui le nomme spécifiquement, elle prime sur la directive générale pour lui seul. Ce mécanisme permet d'autoriser un moteur et d'en exclure un autre, besoin rare et parfaitement supporté. Il constitue une exception apparente à la règle du plus restrictif, qui ne s'applique en réalité qu'entre directives de même portée. Ce cas reste marginal sur un site professionnel ordinaire et il vaut mieux l'éviter, chaque exception compliquant les diagnostics ultérieurs.
Ce que la règle ne couvre pas
Le fichier des robots n'entre pas dans ce mécanisme, car il ne porte pas sur l'indexation mais sur l'exploration. Interdire l'exploration d'une page empêche le robot de lire ses directives, ce qui produit une situation où la page peut rester indexée sans son contenu. Ce n'est pas une contradiction résolue par une règle de priorité, c'est un blocage qui rend la directive invisible. La distinction entre exploration et indexation est le point le plus mal compris de tout le sujet. Explorer, c'est aller lire la page ; indexer, c'est décider de la conserver et de l'afficher en résultat. Une page peut être indexée sans avoir été lue, situation absurde en apparence et parfaitement logique du point de vue du moteur.
Le cas de la balise canonique
Une adresse canonique pointant ailleurs et une directive d'indexation ne se contredisent pas formellement et elles envoient un signal incohérent. Déclarer qu'une page est la version de référence tout en interdisant son indexation laisse le moteur devant un choix impossible. Ces combinaisons produisent des comportements imprévisibles et doivent être évitées. Elles sont pourtant fréquentes sur les sites où plusieurs extensions écrivent chacune une partie des métadonnées. La règle simple consiste à ne jamais déclarer de canonique sur une page que l'on interdit d'indexer.
D'où viennent les directives
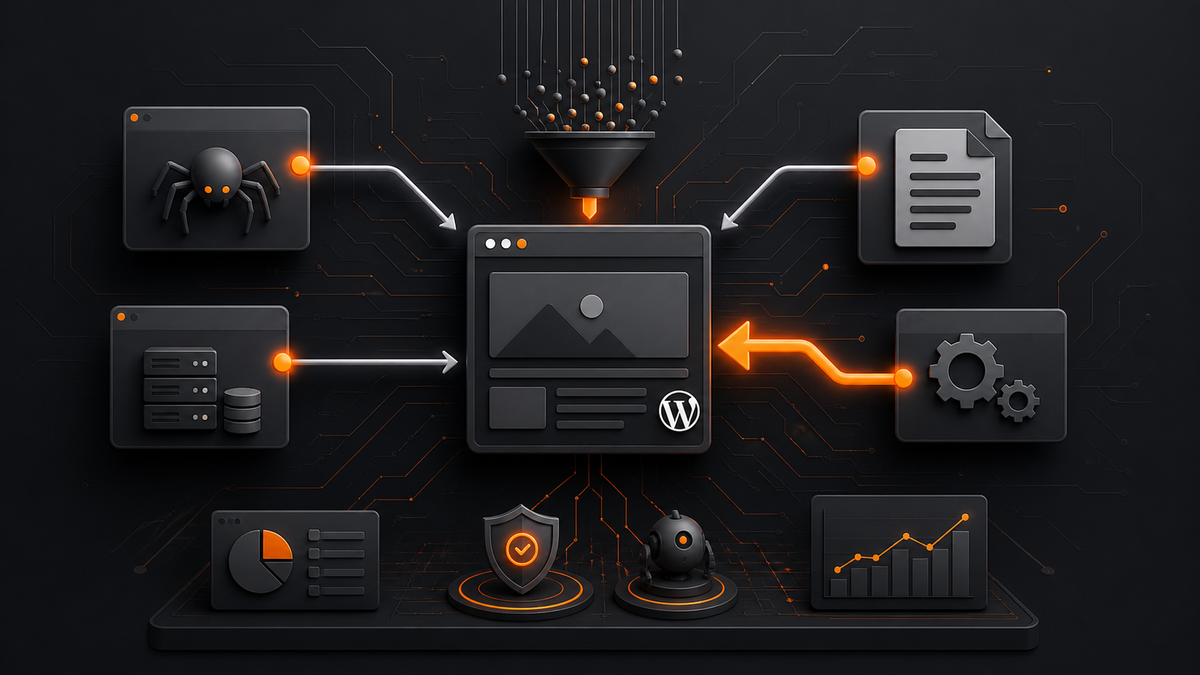
La difficulté du diagnostic ne tient pas à la règle mais au nombre d'endroits susceptibles de produire une directive. En recenser six ou sept sur un site WordPress ordinaire n'a rien d'exceptionnel.
L'extension de référencement
C'est la source la plus courante et la plus visible, avec ses réglages par type de contenu, par taxinomie et par contenu individuel. Un réglage global sur un type de contenu peut être surchargé sur une page précise, ce qui produit des situations où le comportement diffère d'une page à l'autre sans raison apparente. Le premier réflexe consiste donc à ouvrir le réglage de la page concernée, puis celui du type de contenu. Ces deux niveaux expliquent la majorité des cas rencontrés. Certaines extensions ajoutent un troisième niveau par taxinomie, qu'il faut penser à consulter lorsque les deux premiers ne répondent pas.
Le réglage natif de visibilité
La case demandant aux moteurs de ne pas indexer le site, présente dans les réglages de lecture, agit globalement et prime sur tout le reste. Elle est fréquemment laissée active après une mise en ligne, la personne ayant oublié de la décocher. Ce cas produit une absence totale d'indexation qui inquiète beaucoup avant d'être diagnostiquée en trois secondes. C'est le premier point à vérifier sur un site qui n'apparaît nulle part. La correction est instantanée, la réindexation demande en revanche plusieurs semaines, délai qu'il vaut mieux annoncer immédiatement.
Le thème
Certains thèmes écrivent leurs propres balises dans l'en tête du document, parfois conditionnellement selon le type de page. Cette production coexiste alors avec celle de l'extension de référencement, produisant deux balises dont les valeurs peuvent différer. Une recherche dans les fichiers du thème sur le nom de la balise identifie la source en quelques secondes. Ce cas se rencontre surtout sur les thèmes anciens, antérieurs à la généralisation des extensions dédiées. Il peut aussi provenir d'un thème enfant dans lequel un intervenant a ajouté une balise pour un besoin ponctuel, sans la retirer ensuite.
La configuration du serveur
Un en tête posé par une règle de configuration s'applique à un chemin ou à un type de fichier, sans laisser aucune trace dans le code du site. C'est la source la plus difficile à repérer et celle qui produit les diagnostics les plus longs. Elle est fréquente sur les environnements de recette dont la configuration a été copiée en production, Une simple relecture du fichier de configuration du site sur le serveur suffit à trancher, encore faut il y penser et y avoir accès. Ce point est traité dans notre article sur la page désindexée et les actions à mettre en place.
Les extensions tierces
Une extension de boutique, de gestion de membres ou de constructeur de pages peut ajouter ses propres directives sur les pages qu'elle génère. Les pages de panier, de compte et de résultats de recherche interne sont concernées par défaut sur plusieurs solutions. Ce comportement est en général souhaitable et il devient gênant lorsqu'il touche des pages que l'on voulait indexer. Un inventaire des extensions produisant des balises fait partie de tout audit sérieux. Il se mène en recherchant le nom de la balise dans le répertoire des extensions, ce qui donne la liste des fichiers concernés.
Le code ajouté au fil du temps
Les interventions successives laissent parfois des filtres ajoutés dans un fichier de fonctions, une extension maison ou une interface d'ajout de code. Ces ajouts n'ont aucune raison d'être documentés et ils survivent longtemps à leur motif initial. Une recherche sur les termes concernés dans l'ensemble des fichiers du site les fait apparaître. C'est le dernier endroit où chercher et souvent celui qui contient la réponse. Les interfaces permettant d'ajouter du code sans toucher aux fichiers compliquent particulièrement cette recherche, puisque le code réside alors en base.
| Source | Portée | Visibilité au diagnostic |
|---|---|---|
| Réglage natif de visibilité | Site entier | Immédiate dans les réglages |
| Extension de référencement | Par type ou par page | Immédiate dans l'interface |
| Thème | Selon les gabarits | Recherche dans les fichiers |
| Extension tierce | Pages générées | Recherche dans les fichiers |
| Configuration du serveur | Chemin ou type de fichier | Lecture des en têtes de réponse |
| Code ajouté au fil du temps | Variable | Recherche globale |
| Fichier des robots | Exploration seulement | Lecture directe du fichier |
Diagnostiquer efficacement
Une méthode en quatre étapes permet de trancher n'importe quelle situation en quelques minutes, à condition de les mener dans l'ordre.
Lire les en têtes de réponse
La première étape consiste à interroger l'adresse et à examiner les en têtes renvoyés, ce qui se fait en ligne de commande ou depuis l'onglet réseau du navigateur. Une directive présente à ce niveau explique immédiatement le comportement et oriente vers la configuration du serveur. Commencer par là évite de perdre du temps à chercher une balise. Cette étape prend dix secondes et elle est presque toujours sautée. Une commande d'interrogation renvoyant uniquement les en têtes suffit, sans même charger le contenu de la page.
Examiner le code source
La deuxième étape consiste à afficher le code source envoyé par le serveur, et non l'inspecteur du navigateur qui montre l'état après exécution. Une recherche sur le nom de la balise fait apparaître toutes les occurrences, y compris les doublons. Trouver deux balises confirme la présence de deux sources et oriente le reste du diagnostic. Cette confusion entre code source et document rendu est la principale cause d'erreur à cette étape. Les deux vues se ressemblent beaucoup à l'écran et ne décrivent pas du tout le même état du document.
Vérifier ce qui est ajouté après rendu
Une balise ajoutée par un script après le chargement peut être prise en compte lors du rendu par le moteur, avec un décalage. Comparer le code source et l'inspecteur du navigateur révèle ces ajouts. Ce cas est rare et il concerne surtout les applications construites côté navigateur. Il mérite d'être vérifié lorsque les deux premières étapes n'ont rien donné. Une balise ajoutée tardivement peut par ailleurs être vue ou non selon le moment où le rendu intervient, ce qui produit un comportement instable difficile à reproduire.
Employer l'outil d'inspection officiel
L'outil pour webmasters indique ce que le moteur a réellement retenu pour l'adresse concernée, avec le motif exact d'exclusion le cas échéant. C'est la source la plus autorisée et elle règle les discussions. Elle indique notamment si la page est exclue par une directive, par une canonique divergente ou pour une autre raison, distinction essentielle que les autres méthodes ne donnent pas. Son seul défaut est le délai de mise à jour après correction. Il faut compter de quelques jours à plusieurs semaines avant que le changement ne se reflète dans l'outil, ce qui impose de la patience.
Explorer le site en masse
Un outil d'exploration extrait les directives de toutes les pages et permet de repérer les incohérences à l'échelle du site. Un tableau croisant le type de page et la directive appliquée fait apparaître les familles mal configurées. Ce contrôle prend quelques minutes et il révèle presque toujours des cas que personne ne surveillait. Il devrait figurer dans toute prise en main d'un site existant. Le tableau obtenu constitue en outre un excellent point de départ pour discuter avec le client de ce qui doit être indexé ou non.
Croiser avec les journaux
Les journaux du serveur indiquent si le robot passe encore sur les pages concernées. Une page exclue de l'index mais toujours explorée signale que la directive est bien lue, ce qui confirme le diagnostic. Une page ni explorée ni indexée oriente plutôt vers un blocage d'exploration, sujet différent. Cette vérification demande quelques semaines de recul et elle est la plus concluante de toutes. Elle porte sur le comportement observé plutôt que sur une hypothèse, ce qui ferme définitivement le débat.
Répartition des sources identifiées sur des sites présentant des directives d'indexation contradictoires.
Éviter que le problème ne revienne
Une correction ponctuelle ne sert à rien si la cause structurelle demeure, à savoir la multiplicité des sources de directives.
Désigner une source unique
La règle la plus efficace consiste à décider qu'une seule composante produit les directives, en général l'extension de référencement, et à neutraliser toutes les autres. Cette décision doit être écrite et vérifiée après chaque installation d'extension. Elle simplifie radicalement tous les diagnostics ultérieurs. C'est la mesure structurante du sujet et elle demande une demi journée sur un site existant. Le temps consacré se rentabilise dès le premier diagnostic évité.
Ne pas empiler les protections
Ajouter une directive dans le thème par précaution, alors que l'extension en produit déjà une, ne renforce rien et crée une source supplémentaire. Cette accumulation par prudence est le mécanisme même qui produit les contradictions. Une seule déclaration correcte vaut mieux que trois déclarations redondantes. Ce principe vaut pour l'ensemble des métadonnées de référencement. Titres, descriptions et données structurées obéissent exactement à la même logique de source unique.
Traiter le fichier des robots séparément
Ce fichier ne doit jamais être employé pour empêcher une indexation, seulement pour économiser l'exploration de ressources sans intérêt. Confondre les deux usages produit les situations les plus difficiles à corriger, la directive de désindexation devenant illisible. Les principes de rédaction de ce fichier sont détaillés dans notre article sur le robots.txt à l'échelle, son ordre et ses directives.
Contrôler après chaque intervention
Une mise à jour d'extension, un changement de thème ou une reprise de configuration serveur peut modifier les directives sans prévenir. Un contrôle rapide sur trois pages représentatives après chaque intervention majeure suffit à détecter une régression. Ce contrôle prend une minute et il évite de découvrir le problème par une chute de trafic un mois plus tard. Il mérite d'être inscrit dans la procédure de mise en production.
Surveiller les rapports d'indexation
Le nombre de pages exclues par une directive, suivi mensuellement, constitue un indicateur d'alerte. Une hausse soudaine signale qu'une directive s'est appliquée là où elle n'aurait pas dû. Ce suivi ne demande que de noter un chiffre chaque mois, et il détecte les régressions avant qu'elles ne coûtent du trafic. C'est la surveillance la plus économique du sujet.
Documenter la configuration voulue
Une note indiquant quels types de pages doivent être indexés, lesquels ne doivent pas l'être et où se pose le réglage évite qu'un intervenant ultérieur ne modifie un comportement volontaire en le prenant pour une erreur. Cette note tient en dix lignes. Elle rend aussi les audits nettement plus rapides, en distinguant immédiatement les exclusions voulues des exclusions subies. C'est le document qui manque le plus souvent lors d'une reprise de site.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.