Le panier d'un site marchand doit exister quelque part entre le moment où le client ajoute son premier article et celui où il valide sa commande. Ce quelque part n'est pas un détail d'implémentation : selon qu'il s'agit du serveur ou du navigateur du visiteur, le site ne se comporte pas de la même façon en matière de fiabilité des prix, de reprise sur un autre appareil, de performance et de capacité à relancer les paniers abandonnés. Beaucoup d'équipes découvrent ces conséquences après coup, lorsqu'un client se plaint d'un prix qui a changé ou que la relance par courriel se révèle impossible à mettre en place. Nous détaillons ici ce que chaque option implique réellement et comment choisir selon le contexte.
Les deux approches et leur fonctionnement
La distinction porte sur l'endroit où réside la vérité du panier, et non sur l'endroit où il s'affiche. Le rôle du panier dans le parcours d'achat et ses fonctions attendues sont rappelés dans notre article sur le panier e-commerce et son fonctionnement.
Le panier stocké côté serveur
Le contenu du panier est enregistré dans la base de données du site, associé à un identifiant de session ou à un compte client. Le navigateur ne conserve qu'une référence, généralement un cookie contenant cet identifiant. Chaque ajout ou modification déclenche une requête vers le serveur, qui met à jour l'enregistrement et renvoie l'état à jour. C'est le fonctionnement historique des plateformes marchandes et il reste le plus répandu. Il garantit que le serveur connaît à tout instant le contenu exact du panier. Cette connaissance ouvre des possibilités que l'autre approche n'offre pas.
Le panier stocké côté navigateur
Le contenu est enregistré dans l'espace de stockage local du navigateur, sur l'appareil du visiteur. Les ajouts et modifications se font sans aucun appel au serveur, ce qui les rend instantanés. Le serveur ne découvre le panier qu'au moment où le client passe à la commande et le transmet. Cette approche s'est répandue avec les interfaces construites côté navigateur et avec les architectures découplées. Elle offre une réactivité supérieure et elle prive le serveur de toute visibilité intermédiaire. Ce dernier point constitue sa principale limite.
L'approche mixte
Une troisième voie combine les deux : le panier vit dans le navigateur pour la réactivité, et il est synchronisé vers le serveur à intervalle régulier ou à chaque modification importante. Le client obtient l'instantanéité, le serveur conserve la visibilité. Cette solution demande de gérer les conflits lorsque deux appareils modifient le panier, ce qui reste rare en pratique. Elle constitue le meilleur compromis pour un site marchand établi. Son coût de développement est supérieur aux deux options simples. Il se justifie dès que le volume d'affaires rend la relance des paniers abandonnés rentable.
Le rôle du rendu de la page
L'architecture d'affichage du site influence fortement ce choix, un site produit côté serveur se prêtant naturellement au panier serveur. Les différences entre ces modes de production sont expliquées dans notre article sur le rendu côté serveur expliqué sans jargon. Un site construit côté navigateur peut néanmoins conserver un panier serveur, et l'inverse est également possible. Ces deux décisions sont indépendantes même si elles se corrèlent souvent. Les traiter séparément évite de subir un choix par défaut. La question du panier mérite son propre arbitrage.
Le cas du visiteur non identifié
La majorité des paniers sont constitués par des visiteurs non connectés, ce qui pose la question du rattachement. Côté serveur, un identifiant de session anonyme fait le lien, avec une durée de vie limitée. Côté navigateur, le stockage local persiste tant que le visiteur ne nettoie pas son navigateur, parfois plusieurs mois. Cette persistance longue constitue un avantage du stockage local, souvent sous-estimé. Elle pose en revanche la question du prix, sur laquelle nous revenons plus loin. Le comportement à la connexion, avec fusion des deux paniers, doit être défini explicitement.
La durée de conservation
Un panier serveur occupe de l'espace en base et sa purge doit être organisée, généralement après trente à quatre-vingt-dix jours d'inactivité. Un panier local ne coûte rien au site et il survit tant que le navigateur le conserve. Sur un catalogue à panier moyen élevé, une conservation longue augmente sensiblement les retours de visiteurs. Cette durée constitue un paramètre commercial autant que technique. Elle doit être décidée avec la personne qui pilote les ventes. Elle est rarement discutée et souvent laissée à sa valeur par défaut.
Ce que chaque option change concrètement
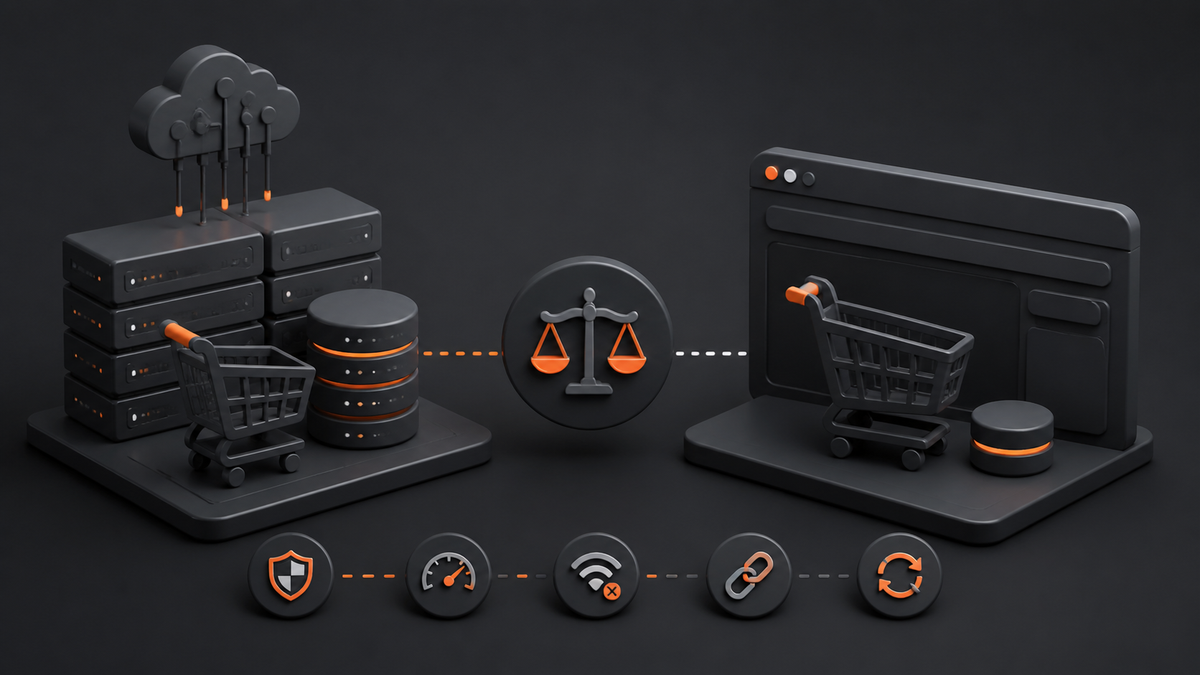
Les différences se manifestent sur cinq terrains, dont l'importance dépend entièrement du type de commerce.
La fiabilité des prix
Un panier local conserve les prix tels qu'ils étaient au moment de l'ajout, parfois plusieurs semaines auparavant. Si le prix a changé entretemps, le client voit un montant qui ne correspond plus à la réalité, et la correction au moment du paiement produit une mauvaise surprise. Un panier serveur peut recalculer les prix à chaque affichage, ce qui garantit la cohérence. La bonne pratique, quelle que soit l'approche, consiste à revalider systématiquement prix et disponibilité au passage en commande. Cette validation est indispensable et elle est parfois omise sur les architectures locales. Son absence expose à des litiges et à des ventes à perte.
La reprise sur un autre appareil
Un client qui remplit son panier sur son téléphone le midi et souhaite finaliser sur son ordinateur le soir ne retrouvera rien avec un stockage local. Le panier serveur, associé à un compte, permet cette continuité. Sur un secteur où la réflexion s'étale sur plusieurs jours et plusieurs appareils, cette différence pèse sur le taux de conversion. Elle suppose néanmoins que le client soit connecté, ce qui reste minoritaire. L'approche mixte règle le cas en synchronisant dès qu'une identification survient. C'est l'un des arguments les plus forts en faveur de cette approche.
La relance des paniers abandonnés
Envoyer un rappel à un client ayant laissé des articles suppose que le serveur connaisse le contenu du panier et dispose d'une adresse. Un panier purement local rend cette relance impossible tant que le client n'a pas transmis ses coordonnées. Compte tenu des taux d'abandon habituels, détaillés dans notre article sur le taux d'abandon de panier, cette perte de levier est significative. La relance figure parmi les actions au meilleur rendement d'un site marchand. Y renoncer pour une raison technique constitue rarement un bon arbitrage. Ce point suffit souvent à trancher la question.
La réactivité perçue
Ajouter un article avec un panier local est instantané, l'interface se mettant à jour sans attendre de réponse. Avec un panier serveur, un aller-retour de deux à cinq cents millisecondes s'intercale, perceptible sur une connexion mobile. Cette différence se corrige en grande partie par une mise à jour optimiste de l'interface, qui affiche le résultat attendu avant confirmation. Cette technique demande de gérer le cas d'échec, rare mais réel. Correctement implémentée, elle supprime l'écart perçu. Elle constitue le complément indispensable d'un panier serveur sur un site moderne.
La mesure et l'analyse
Un panier serveur permet de suivre les ajouts, les retraits et les abandons directement dans les données du site, sans dépendre d'un outil externe soumis au consentement. Cette visibilité produit des analyses fiables sur les articles souvent retirés ou sur les paniers restés inachevés. Un panier local impose de passer par la mesure côté navigateur, avec les pertes de données que cela implique. Sur un site où l'analyse du parcours d'achat compte, cette différence est importante. Elle est rarement évoquée lors du choix d'architecture. Elle se découvre au moment où l'on cherche à comprendre les abandons.
La résistance aux manipulations
Un panier stocké dans le navigateur est modifiable par le visiteur, qui peut en changer les prix ou les quantités avec les outils de développement. Cette manipulation n'a aucune conséquence si le serveur revalide tout au moment de la commande, ce qui doit être le cas absolument. Un panier serveur ne présente pas ce risque par construction. La règle reste identique dans les deux cas : ne jamais faire confiance à ce qui vient du navigateur. Cette règle est parfois oubliée sur les architectures locales, où le panier transmis est accepté tel quel. L'erreur permet alors de commander à un prix choisi par le client.
| Critère | Panier serveur | Panier navigateur | Approche mixte |
|---|---|---|---|
| Fiabilité des prix | Élevée | Faible sans revalidation | Élevée |
| Reprise multi-appareils | Oui si connecté | Non | Oui si connecté |
| Relance des abandons | Possible | Impossible | Possible |
| Réactivité brute | Moyenne | Excellente | Excellente |
| Charge serveur | Significative | Nulle | Modérée |
| Coût de développement | Faible | Moyen | Élevé |
Choisir selon le contexte
Aucune option n'est supérieure dans l'absolu et quelques critères simples orientent efficacement la décision.
Le panier moyen et le délai de décision
Un achat impulsif à faible montant se décide en quelques minutes, sur un seul appareil, ce qui rend la continuité inutile. Un achat réfléchi à plusieurs centaines d'euros s'étale sur des jours et plusieurs appareils, ce qui rend la continuité déterminante. Relever le délai médian entre le premier ajout et la commande, disponible dans les données du site, tranche immédiatement. Ce chiffre est rarement consulté et il est décisif. Un délai supérieur à vingt-quatre heures plaide fortement pour un panier serveur. Un délai de quelques minutes rend le sujet secondaire.
La volatilité des prix
Un catalogue dont les prix changent rarement tolère très bien un panier local. Un site pratiquant des promotions fréquentes, des prix dynamiques ou des remises par quantité s'expose à des incohérences permanentes. Le recalcul systématique côté serveur devient alors la seule approche tenable. Cette contrainte est souvent découverte après la mise en production, lors de la première campagne promotionnelle. L'anticiper évite une reprise coûteuse. La question à poser est simple : combien de fois par mois un prix change-t-il.
Le volume de trafic
Un panier serveur génère une requête à chaque modification, ce qui représente une charge notable sur un site à fort trafic. Cette charge se dimensionne et elle a un coût d'infrastructure. Un panier local reporte entièrement ce coût sur les appareils des visiteurs. Sur un site à très fort volume avec un panier moyen faible, cet argument devient sérieux. Il reste minoritaire face aux considérations commerciales sur la plupart des sites. Le chiffrer avant de décider évite de trancher sur une impression.
La part du trafic identifié
Si une majorité de clients dispose d'un compte et se connecte, le panier serveur exprime tout son potentiel. Si la quasi totalité des achats se fait sans compte, une partie des avantages disparaît. Relever cette proportion dans les données existantes prend deux minutes. Elle varie énormément selon les secteurs, de moins de dix pour cent sur certains commerces à plus de soixante sur d'autres. Cette mesure oriente également les efforts sur la création de compte. Elle constitue un indicateur utile au delà de la question du panier.
L'architecture existante
Sur un site fonctionnant déjà avec une plateforme marchande classique, le panier serveur est fourni et le remplacer représente un chantier considérable pour un gain incertain. Sur une architecture découplée, l'inverse est vrai. Le coût de migration doit entrer dans la décision au même titre que les mérites théoriques de chaque option. Beaucoup de refontes se justifient mal une fois ce coût chiffré. Une amélioration incrémentale de l'existant produit souvent davantage. Cette évaluation honnête évite des chantiers de plusieurs mois.
Les contraintes réglementaires
Le stockage local relève des règles sur les traceurs lorsqu'il sert à autre chose qu'au strict fonctionnement du service demandé. Un panier constitue précisément une fonctionnalité demandée par l'utilisateur, ce qui le place généralement dans les exemptions. Nous ne sommes pas juristes et cette appréciation dépend de l'usage exact qui est fait des données. La prudence consiste à ne stocker localement que ce qui est nécessaire au panier, sans y adjoindre de données de profilage. Cette séparation simplifie considérablement l'analyse. Elle constitue une bonne pratique indépendamment de la réglementation.
Proportions observées sur des sites marchands disposant d'un panier serveur associé à un compte client.
Les règles valables dans tous les cas
Quelle que soit l'option retenue, quelques principes conditionnent la fiabilité du dispositif.
Revalider systématiquement à la commande
Prix, disponibilité, promotions et frais de livraison doivent être recalculés côté serveur au moment de la validation, sans exception. Cette règle protège contre les manipulations et contre les incohérences dues au temps écoulé. Le client doit être informé clairement de toute différence avant de payer. Un écart découvert après le paiement produit un litige et une perte de confiance. Cette validation représente quelques dizaines de lignes de code. Elle est non négociable sur un site marchand.
Gérer la fusion à la connexion
Un visiteur anonyme qui se connecte peut avoir un panier local et un panier déjà enregistré sur son compte. Le comportement doit être décidé explicitement : addition, remplacement ou question posée au client. L'addition constitue le choix le plus fréquent et le moins surprenant. Ce cas est régulièrement oublié et il produit des pertes de panier silencieuses. Le tester fait partie de la recette obligatoire. Il concerne une part non négligeable des sessions.
Prévoir la limite de taille
Le stockage local du navigateur est limité et un panier de plusieurs centaines de lignes peut le dépasser. Côté serveur, la limite est celle de la base et elle est bien plus lointaine. Prévoir un plafond raisonnable, avec un message clair au delà, évite les comportements erratiques. Ce cas concerne surtout les sites destinés aux professionnels, où les commandes comportent parfois des centaines de références. Sur ces sites, le panier serveur s'impose pour cette seule raison. La limite doit être testée avec des données réalistes.
Traiter la suppression et la vidange
Le client doit pouvoir retirer un article et vider son panier sans difficulté, y compris depuis un appareil différent. Une suppression qui ne se propage pas produit un panier fantôme particulièrement agaçant. Ce comportement doit être testé sur les deux appareils dans le cas d'une approche mixte. Il fait partie des scénarios que les tests fonctionnels oublient. Sa défaillance génère des réclamations difficiles à diagnostiquer. Un test explicite règle la question.
Journaliser les modifications
Enregistrer les ajouts, retraits et modifications avec leur horodatage permet de reconstituer un parcours en cas de réclamation. Cette journalisation alimente également les analyses sur les hésitations des clients. Sa durée de conservation doit être limitée et elle contient des données personnelles. Un identifiant technique plutôt qu'une adresse suffit pour l'essentiel des usages analytiques. Cette trace se révèle précieuse au premier litige. Elle se met en place en quelques lignes.
Mesurer avant de changer d'approche
Une migration d'architecture de panier représente plusieurs semaines de travail et elle doit reposer sur des chiffres. Le délai médian de décision, la part de trafic identifié, la fréquence des changements de prix et le taux d'abandon constituent les quatre indicateurs pertinents. Les relever prend une heure et ils orientent la décision bien mieux qu'une préférence technique. Documenter la décision avec ces chiffres évite qu'elle ne soit remise en cause tous les six mois. Cette trace vaut également pour le prestataire suivant. Elle transforme un débat d'opinion en un arbitrage argumenté. Elle se range avec les autres décisions d'architecture du projet, où elle sera relue au bon moment.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.