Un code promotionnel générique, communiqué à une liste ou imprimé sur un support, finit toujours sur un site d'agrégation de bons de réduction. Le remède connu consiste à distribuer un code différent à chaque destinataire, valable une seule fois. L'idée est simple et sa mise en œuvre pose trois questions qui ne se règlent pas d'elles mêmes : comment produire des codes non devinables en grand nombre, comment garantir qu'un code ne peut être consommé qu'une fois même lorsque deux commandes arrivent en même temps, et comment suivre ce qui a été distribué. Cet article traite ces trois points et les pièges qui les accompagnent.
Ce que le code unique résout et ce qu'il ne résout pas
Avant de construire quoi que ce soit, il vaut la peine de préciser le problème traité, car le code individuel n'est pas la réponse à toutes les fuites de marge. Il protège contre la diffusion publique d'un code unique, ce qui est la fuite la plus spectaculaire et la plus rapide. Il ne protège ni contre la création de comptes multiples par un même acheteur, ni contre le cumul avec d'autres mécaniques, ni contre une opération mal chiffrée au départ. Les principes généraux de ces mécaniques sont rappelés dans notre article sur le code promo en e-commerce, sa définition et son usage.
La diffusion incontrôlée
Un code générique communiqué à cinq cents personnes se retrouve en ligne dans les jours qui suivent, sans qu'aucune de ces personnes n'ait eu d'intention malveillante : il suffit d'une capture d'écran partagée. Le volume consommé devient alors sans rapport avec la cible visée, et l'opération coûte plusieurs fois le budget prévu. Le code individuel supprime purement et simplement ce risque, un code publié n'étant utilisable que par la première personne qui le trouve. C'est le bénéfice principal et il justifie à lui seul le travail de mise en place. Il change aussi la façon de communiquer, puisqu'un code personnel peut être annoncé comme tel, ce qui augmente son attractivité perçue.
La traçabilité de la distribution
Un code individuel permet de savoir qui a reçu quoi et qui a utilisé son code, information impossible à obtenir avec un code générique. Cette traçabilité mesure directement l'efficacité de chaque canal de distribution et de chaque segment de destinataires. Elle transforme une opération commerciale en expérience mesurable. C'est un bénéfice secondaire souvent plus utile, sur la durée, que la protection contre la diffusion. Il permet notamment de comparer deux formulations d'offre sur deux moitiés d'une même liste, sans instrumentation particulière.
Les comptes multiples
Rien n'empêche un acheteur déterminé de créer plusieurs comptes pour recevoir plusieurs codes, si la distribution est automatique et ouverte. Le code individuel ne traite pas ce cas, qui relève des règles d'attribution et non du mécanisme de code. Limiter l'attribution aux comptes existants avant une date, ou aux clients ayant déjà commandé, referme la plupart de ces contournements. Ce point doit être tranché au moment de définir l'opération. Il relève du commerce plutôt que de la technique et il gagne à être discuté avec la personne qui portera la responsabilité du budget.
Le cumul avec d'autres remises
Un code unique s'ajoute aux prix promotionnels et aux remises de compte exactement comme un code générique. Son unicité ne dit rien de son cumul, et la confusion entre les deux notions est fréquente. La politique de cumul doit donc être définie séparément, sujet que nous développons dans notre article sur les promotions cumulables et la modélisation des règles.
Le coût de mise en place
Générer, distribuer et vérifier des codes individuels demande un développement ou une extension, là où un code générique se crée en trente secondes. Ce coût se justifie dès que le volume de destinataires dépasse quelques dizaines ou que la remise consentie est importante. En dessous, un code générique avec une limite globale d'utilisation couvre le besoin à moindre frais. L'arbitrage se fait sur le montant en jeu plutôt que sur un principe. Une remise de cinq euros distribuée à quarante personnes ne justifie évidemment pas le même dispositif qu'une remise de cinquante euros distribuée à cinq mille.
Le cas des supports imprimés
Un code figurant sur un flyer, un catalogue ou un ticket de caisse ne peut pas être individuel si le support est identique pour tous. Un code par lot, avec une limite d'utilisation correspondant au tirage, constitue le compromis courant. Les supports personnalisés, courrier nominatif ou étiquette imprimée à la commande, autorisent en revanche l'individualisation complète. Ce choix relève de la logistique autant que de la technique. Le coût d'impression variable est aujourd'hui modeste, ce qui rend l'individualisation accessible même sur des supports physiques.
Générer des codes corrects
La génération paraît triviale et elle concentre plusieurs erreurs qui se paient cher, notamment sur les codes destinés à être saisis à la main.
L'imprévisibilité avant tout
Un code construit à partir d'un numéro de commande, d'un identifiant client ou d'une date est devinable, ce qui permet à quiconque comprend le motif de générer des codes valides. La règle est donc d'employer une source d'aléa cryptographique, jamais une fonction de hasard ordinaire ni une valeur dérivée d'une donnée connue. Cette exigence est la même que pour un jeton de session et elle est régulièrement ignorée sur les codes promotionnels, perçus comme moins sensibles. Ils le sont pourtant tout autant, puisqu'ils engagent directement de l'argent. La plupart des langages proposent une fonction dédiée en une ligne, ce qui rend l'erreur d'autant moins excusable.
La longueur suffisante
Un code de six caractères pris dans un alphabet de vingt cinq symboles offre environ deux cent millions de combinaisons, ce qui paraît beaucoup et devient insuffisant face à un essai automatisé si aucune limitation n'est posée. Huit à dix caractères constituent un compromis raisonnable entre sécurité et confort de saisie. Au delà, la saisie manuelle devient pénible et les erreurs se multiplient. La longueur doit être choisie en fonction du mode de saisie plutôt que par précaution abstraite. Un code cliqué depuis un courriel, jamais saisi à la main, peut être nettement plus long sans aucun inconvénient.
L'alphabet à retenir
Les caractères ambigus doivent être écartés : le zéro et la lettre O, le un et la lettre I ou le L minuscule, le cinq et le S. Leur présence multiplie les erreurs de saisie et les appels au support. Un alphabet réduit aux majuscules non ambiguës et à quelques chiffres, soit une trentaine de symboles, règle la question. Cette attention paraît anecdotique et elle réduit sensiblement le volume de réclamations sur les opérations de grande ampleur. Accepter la saisie en minuscules et ignorer les espaces au moment de la vérification complète utilement cette précaution.
Le préfixe lisible
Ajouter un préfixe court identifiant l'opération, suivi de la partie aléatoire, facilite considérablement l'exploitation. Le support reconnaît l'opération d'un coup d'œil, les exports se trient immédiatement et les statistiques se construisent sans jointure. Ce préfixe ne doit évidemment pas raccourcir la partie aléatoire, qui garde sa longueur propre. C'est un ajout gratuit dont le bénéfice se constate au premier appel client. Il permet aussi de repérer immédiatement un code appartenant à une opération terminée, sans avoir à interroger la base.
Les collisions
Deux codes identiques générés par hasard doivent être impossibles, ce qui suppose une contrainte d'unicité au niveau de la base plutôt qu'une simple vérification avant insertion. Sur une génération de masse, la vérification préalable laisse une fenêtre où deux processus peuvent produire le même code. La contrainte d'unicité en base transforme cette situation en erreur d'insertion, que le code de génération traite en réessayant. Ce mécanisme est simple et il garantit l'absence de doublon quelles que soient les conditions. Le nombre de tentatives nécessaires reste négligeable tant que l'espace des codes possibles dépasse largement le volume généré.
La génération de masse
Produire dix mille codes doit se faire par lot, en une seule transaction, plutôt qu'un par un avec un aller retour par code. La différence de temps se compte en minutes contre plusieurs dizaines de minutes. Prévoir également un identifiant de lot, enregistré sur chaque code, permet de retrouver, exporter ou invalider un ensemble en une opération. Cette organisation par lot est ce qui rend le dispositif administrable dans le temps. Sans elle, une opération terminée laisse des codes dispersés qu'il devient impossible de retrouver proprement.
| Décision | Choix conseillé | Motif |
|---|---|---|
| Source d'aléa | Générateur cryptographique | Codes non devinables |
| Longueur | Huit à dix caractères | Équilibre sécurité et saisie |
| Alphabet | Majuscules non ambiguës | Moins d'erreurs de saisie |
| Préfixe | Court, propre à l'opération | Exploitation et support |
| Unicité | Contrainte en base | Aucun doublon possible |
| Consommation | Mise à jour conditionnelle | Résiste aux commandes simultanées |
| Expiration | Date sur chaque code | Fin d'opération maîtrisée |
Garantir un seul usage
C'est le point technique le plus délicat et celui où les implantations naïves échouent, non pas en usage normal mais exactement au moment où l'opération fonctionne bien.
Le piège de la vérification puis mise à jour
L'implantation naturelle consiste à lire le code, vérifier qu'il n'est pas consommé, puis le marquer comme consommé. Entre la lecture et l'écriture, une seconde requête peut lire la même valeur et conclure la même chose, ce qui permet deux utilisations. Ce scénario paraît improbable et il se produit dès qu'un même code est essayé deux fois rapidement, situation courante lorsqu'un acheteur clique deux fois sur le bouton de validation. C'est le défaut le plus répandu sur ce type de dispositif. Il ne se manifeste jamais en développement, où les requêtes arrivent une par une, et il se révèle exactement au moment où l'opération rencontre du succès.
La mise à jour conditionnelle
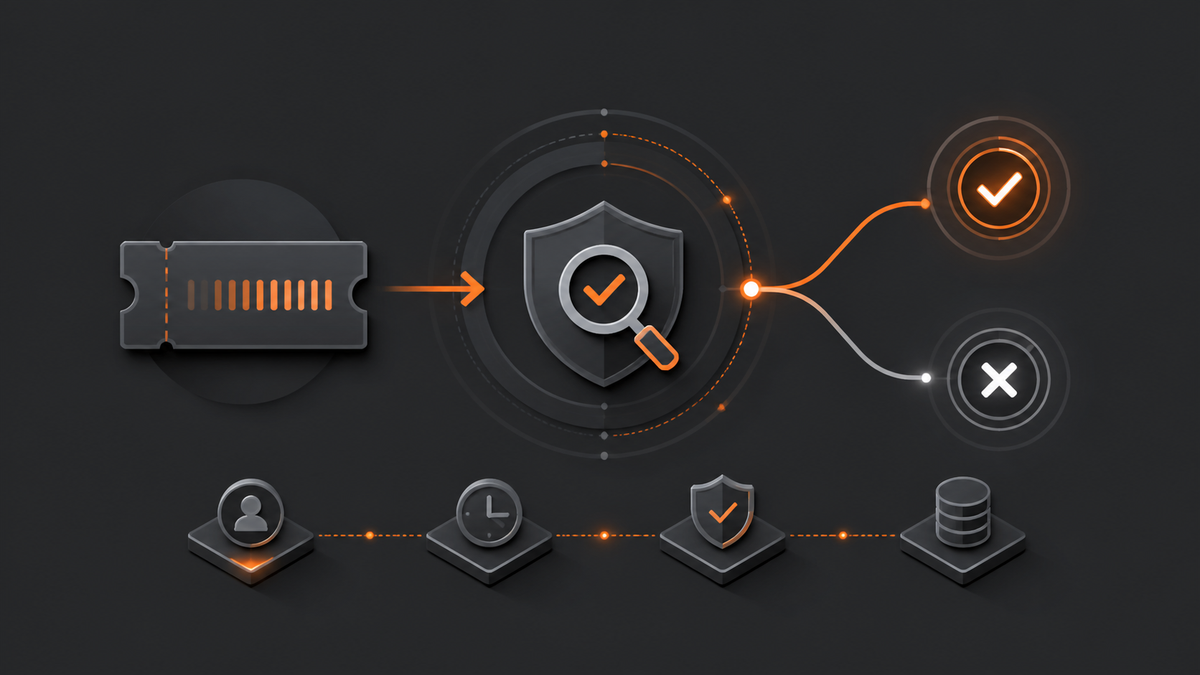
La solution consiste à effectuer la consommation par une seule instruction de mise à jour portant sa propre condition, du type marquer ce code comme consommé si et seulement s'il ne l'est pas déjà. Le nombre de lignes affectées indique si l'opération a réussi. Une seule des deux requêtes concurrentes obtiendra une ligne modifiée, l'autre obtiendra zéro. Ce mécanisme est atomique par construction et il ne demande ni verrou explicite ni transaction complexe. Il tient en une requête et il constitue la seule implantation réellement sûre de la consommation.
La transaction avec la commande
La consommation du code doit être liée à la création de la commande dans une même transaction. Si la commande échoue après la consommation, le code doit redevenir disponible, faute de quoi l'acheteur perd son avantage sans avoir rien acheté. Cette symétrie est souvent oubliée et elle produit des réclamations difficiles à traiter. Une transaction englobant les deux opérations règle la question proprement. Lorsque la création de commande passe par un prestataire externe, la compensation doit être explicite plutôt que confiée à la transaction.
Le cas du paiement différé
Un paiement par virement ou par chèque crée une commande en attente pendant plusieurs jours. Le code doit il être consommé immédiatement ou à la réception du paiement. Consommer immédiatement bloque le code sur une commande qui peut ne jamais être payée ; consommer tardivement laisse le code réutilisable entre temps. La réponse courante consiste à réserver le code à la commande, avec une expiration de la réservation, ce qui demande un troisième état en plus de disponible et consommé. Une réservation expirant après quelques jours, libérée par une tâche planifiée, couvre correctement ce cas de figure.
L'annulation et le remboursement
Une commande annulée pose la question du sort du code. Le rendre systématiquement disponible ouvre un contournement, l'acheteur pouvant commander puis annuler indéfiniment. Ne jamais le rendre pénalise les annulations légitimes. La pratique raisonnable consiste à le rendre disponible sur annulation avant expédition, avec une limite du nombre de restitutions, et à ne pas le rendre après. Cette règle doit être écrite et connue du service client. Sans elle, chaque annulation donne lieu à une décision au cas par cas, ce qui produit des traitements incohérents entre clients.
La vérification côté serveur uniquement
Un contrôle effectué dans le navigateur, pour afficher immédiatement le montant remisé, ne constitue jamais une validation. La consommation doit être décidée par le serveur au moment de l'enregistrement de la commande, et le montant final recalculé à ce moment. Une implantation faisant confiance au montant transmis par le navigateur est exploitable en quelques minutes. Ce principe vaut pour l'ensemble du calcul de panier et il est encore trop souvent négligé. Le contrôle est simple à mener : modifier le montant transmis et vérifier que la commande est refusée.
Taux d'utilisation constatés sur des opérations menées avec des codes individuels distribués par plusieurs canaux.
Distribuer et suivre
La partie technique réglée, l'exploitation quotidienne détermine si l'opération produit les résultats attendus.
Associer le code au destinataire
Enregistrer, pour chaque code, à qui il a été attribué et par quel canal permet toutes les analyses ultérieures. Cette association constitue une donnée personnelle, ce qui impose de définir une durée de conservation et une finalité. Nous ne sommes pas juristes et ce point mérite un avis compétent selon votre situation. Techniquement, un simple champ suffit et il doit être purgé en même temps que le reste des données de l'opération. Conserver l'identifiant du destinataire plutôt que ses coordonnées complètes réduit déjà sensiblement le volume conservé.
Choisir le canal de distribution
Un code peut partir par courriel, s'afficher dans l'espace client, être imprimé sur un support nominatif ou remis en main propre. Chaque canal a son taux d'utilisation propre, généralement très différent des autres. Employer un préfixe distinct par canal permet de mesurer cet écart sans instrumentation supplémentaire. Cette comparaison oriente les opérations suivantes bien mieux qu'une intuition. Les écarts constatés dépassent souvent un facteur cinq, ce qui rend l'arbitrage évident dès la première opération mesurée.
Prévoir l'expiration
Chaque code doit porter une date de fin, y compris lorsque l'opération n'a pas de terme annoncé. Un code sans expiration finit par être utilisé deux ans plus tard, sur une commande que personne n'avait prévue, avec des conditions tarifaires qui n'existent plus. Une expiration à six mois par défaut constitue une précaution raisonnable. Elle doit être communiquée au destinataire, faute de quoi la réclamation est légitime. Mentionner la date directement à côté du code, dans le message qui le transmet, suffit à couvrir ce point.
Suivre le taux d'utilisation
Le rapport entre codes utilisés et codes distribués constitue l'indicateur central de l'opération. Un taux inférieur à quelques pour cent signale un problème de ciblage, d'attractivité de l'offre ou de visibilité du code. Ce chiffre se relève par une requête simple et il devrait être suivi chaque semaine pendant l'opération. Il permet d'ajuster avant la fin plutôt que de constater après. Une relance ciblée sur les destinataires n'ayant pas utilisé leur code produit d'ailleurs souvent un second pic d'utilisation.
Détecter les anomalies
Un volume anormal d'essais de codes invalides, provenant d'une même origine, signale une tentative de devinage. Une limitation du nombre d'essais par session et par adresse ferme ce chemin, avec les mêmes mécanismes que pour un formulaire de connexion. Cette protection est indispensable dès que les codes sont courts. Son absence est ce qui rend un alphabet réduit réellement dangereux. Quelques essais par minute et par session suffisent à l'usage légitime et rendent le devinage impraticable.
Nettoyer après l'opération
Les codes non utilisés doivent être invalidés à la fin de l'opération, et les données de distribution purgées selon la durée retenue. Conserver des milliers de codes valides indéfiniment constitue un risque dormant, notamment lors d'une fuite de base. Une invalidation par lot, possible grâce à l'identifiant de lot, prend une requête. Cette étape de clôture est presque toujours oubliée, comme le sont les réglages fins décrits dans notre article sur les codes promotionnels WooCommerce et leurs restrictions.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.