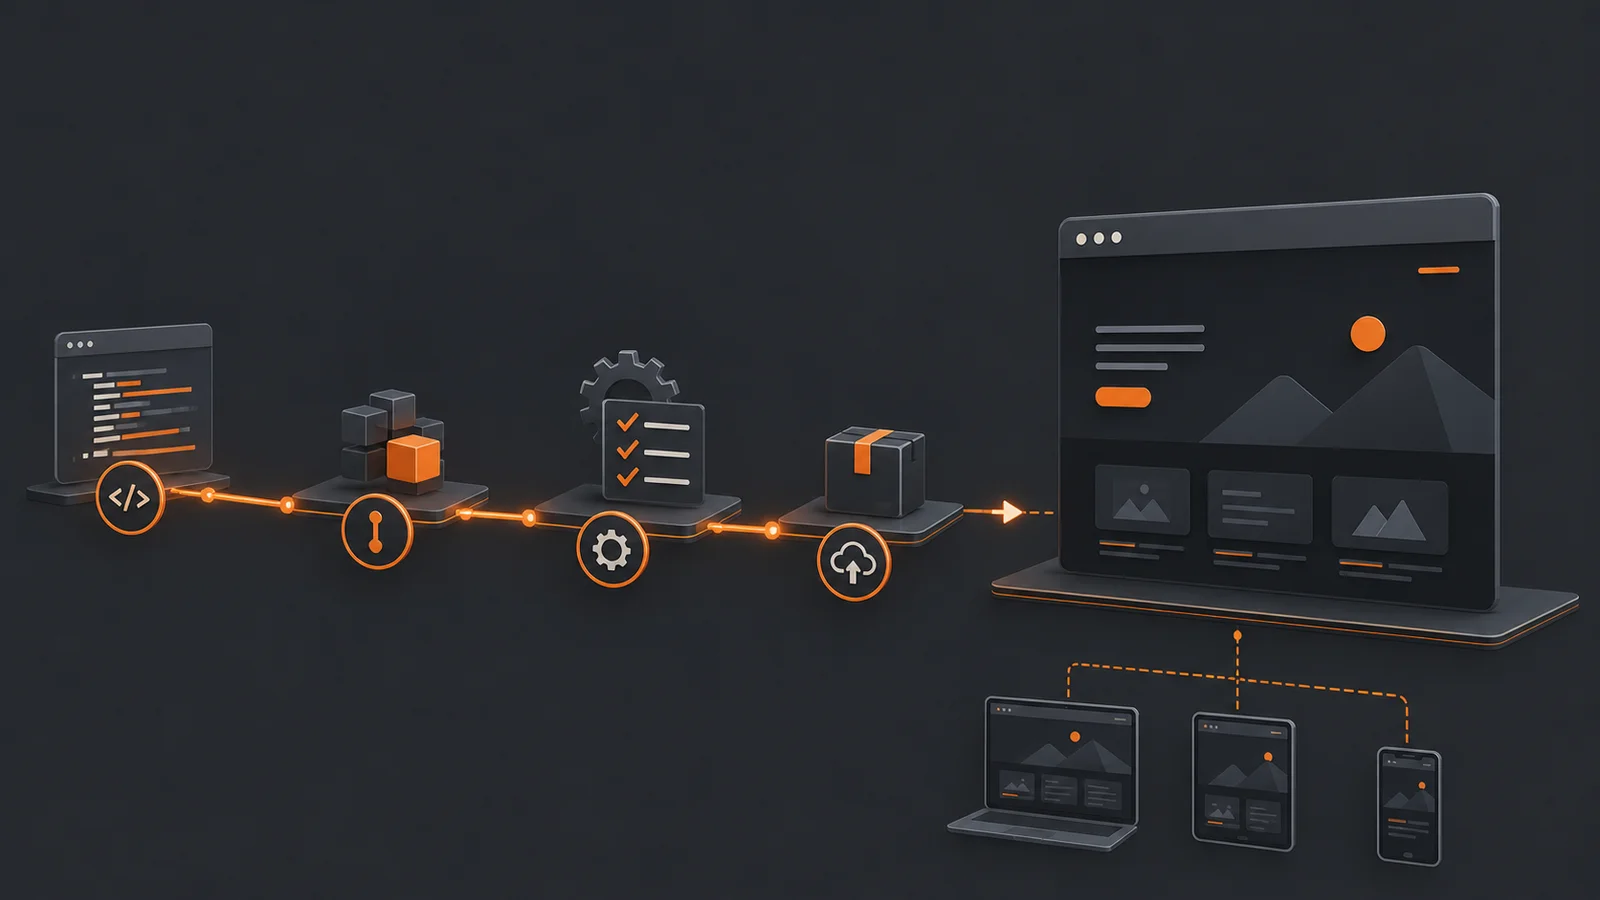
L'intégration continue évoque des chaînes de traitement complexes, des grappes de serveurs et des équipes de dix développeurs. Sur un site vitrine maintenu par une personne, elle se réduit à quelques vérifications lancées automatiquement à chaque modification et à un déploiement qui remplace le transfert manuel de fichiers. Ce dispositif prend une demi journée à mettre en place et il supprime la classe d'incidents la plus fréquente sur ce type de site : le fichier oublié, la version envoyée depuis le mauvais dossier, la modification écrasée par une autre. Cet article décrit la mise en place minimale et ce qu'elle apporte réellement.
Ce que l'on cherche à obtenir
Le bénéfice attendu doit être posé avant de choisir un outil, faute de quoi on met en place une machinerie dont on n'exploite que dix pour cent. Sur un petit projet, trois objectifs suffisent à justifier l'effort. Le vocabulaire et le fonctionnement de ces chaînes sont détaillés dans notre article sur le fonctionnement de CircleCI, ses pipelines, jobs et workflows.
Supprimer le transfert manuel
Envoyer des fichiers par transfert, à la main, est la source d'incident la plus banale et la plus évitable : un fichier oublié, un dossier écrasé, une version de développement envoyée en production. Un déploiement automatique élimine cette catégorie entière de problèmes. Il rend aussi le déploiement reproductible, ce qui signifie que la même opération produit toujours le même résultat. C'est le bénéfice le plus immédiat et le plus visible au quotidien. Il suffit généralement à convaincre une personne réticente, l'économie de temps se constatant dès la première mise en ligne.
Savoir ce qui est en ligne
Sur un site déployé à la main, personne ne sait exactement quelle version tourne, ni quelles modifications locales n'ont jamais été envoyées. Un déploiement lié au dépôt de code établit une correspondance exacte entre ce qui est en ligne et ce qui est versionné. Cette certitude change complètement la façon d'intervenir, notamment lorsqu'un problème survient. Elle est la condition d'un retour arrière fiable. Sans correspondance exacte entre le dépôt et la production, revenir en arrière revient à espérer que la copie locale soit à jour.
Attraper les erreurs avant la mise en ligne
Une erreur de syntaxe, un lien cassé ou une image manquante se découvrent en général par un visiteur. Quelques vérifications automatiques, lancées avant chaque déploiement, les attrapent en amont pour un coût nul. Ces vérifications n'ont pas besoin d'être exhaustives pour être utiles : trois contrôles bien choisis suffisent à éliminer l'essentiel. Elles ont aussi une vertu pédagogique, en signalant immédiatement une erreur pendant qu'on a encore le contexte en tête.
Ce qui n'est pas l'objectif
Sur un site vitrine, il ne s'agit pas de construire une couverture de tests complète, ni de mettre en place des environnements éphémères, ni d'orchestrer des déploiements progressifs. Ces pratiques ont leur place sur des applications, pas sur un site de quinze pages. Vouloir tout mettre en place produit un dispositif que personne ne maintient et qui finit désactivé. La bonne mesure est ce qui rend le quotidien plus sûr sans ajouter de charge. Le test pratique consiste à se demander, pour chaque étape ajoutée, quel incident réellement rencontré elle aurait évité.
Le préalable indispensable
Tout cela suppose que le code du site soit versionné dans un dépôt, ce qui n'est pas encore le cas de tous les sites vitrines. Si ce n'est pas fait, c'est par là qu'il faut commencer, indépendamment de toute question d'automatisation. Le versionnement apporte à lui seul l'essentiel de la valeur : historique, comparaison, retour arrière, travail à plusieurs. L'intégration continue n'en est que le prolongement naturel. Un site vitrine non versionné devrait donc voir ce chantier traité avant toute discussion sur l'automatisation.
Ce qui reste hors du dépôt
La base de données, les fichiers téléversés et les identifiants de connexion ne doivent jamais figurer dans le dépôt. Ils se traitent par les sauvegardes et par les variables d'environnement, ce qui constitue une distinction structurante. Confondre le code et les données produit des déploiements qui écrasent les contenus, incident particulièrement désagréable. Cette séparation doit être posée dès le départ. Elle se matérialise par un fichier d'exclusions dans le dépôt et par une liste d'exclusions au déploiement, les deux devant rester cohérentes.
Choisir les vérifications utiles
La tentation consiste à ajouter tout ce que l'on connaît. Sur un petit site, quelques contrôles ciblés produisent l'essentiel du bénéfice pour un temps d'exécution négligeable.
La validation de syntaxe
Un contrôle de syntaxe sur les fichiers du langage employé attrape les erreurs les plus grossières avant qu'elles n'atteignent le serveur. Il s'exécute en quelques secondes et il ne demande aucune configuration. C'est le premier contrôle à poser et le plus rentable. Sur un site où une erreur de syntaxe produit une page blanche, il évite l'incident le plus visible qui soit. Il couvre également les fichiers de configuration et les gabarits, souvent modifiés dans l'urgence.
Le respect des conventions
Un outil d'analyse statique signale les constructions douteuses, les variables inutilisées et les écarts par rapport aux conventions retenues. Sur un projet à plusieurs intervenants, il évite les discussions de style et il maintient une homogénéité. Sur un projet à une personne, il attrape les distractions. Son réglage initial demande une heure et il ne bouge plus ensuite. Il vaut mieux partir d'un jeu de règles standard et l'assouplir au besoin que de construire sa propre configuration de zéro.
La détection des secrets
Un contrôle cherchant des motifs ressemblant à des identifiants ou des clés dans les fichiers ajoutés évite la fuite la plus classique. Un mot de passe versionné par mégarde reste dans l'historique même après suppression, ce qui rend la correction pénible. Ce contrôle s'ajoute en quelques lignes et il a déjà sauvé beaucoup de projets. Il devrait être systématique sur tout dépôt. Les plateformes proposent d'ailleurs souvent cette détection en option, ce qui réduit la mise en place à un simple réglage.
La vérification des liens
Sur un site statique ou généré, un contrôle des liens internes après construction attrape les références cassées. Cette vérification est plus difficile sur un site dynamique, où les adresses dépendent de la base. Elle reste possible en la menant sur l'environnement de recette après déploiement. C'est une des rares vérifications qui portent sur le rendu plutôt que sur le code. À ce titre, elle attrape des problèmes qu'aucune analyse de fichiers ne verrait, notamment les références construites dynamiquement.
Les tests fonctionnels minimaux
Trois ou quatre tests vérifiant que la page d'accueil répond, que le formulaire de contact s'affiche et que la page de mentions légales existe suffisent à détecter une catastrophe. Ils s'écrivent en une heure et ne demandent aucun cadre de test sophistiqué. Leur intérêt tient moins à ce qu'ils vérifient qu'à leur capacité à signaler qu'une mise en ligne a mal tourné. Cette approche minimale est décrite dans notre article sur la manière de tester un site PHP sans framework de test.
Ce qui ne vaut pas la peine
Les tests unitaires exhaustifs, la mesure de couverture et les analyses de sécurité approfondies demandent un investissement disproportionné sur un site vitrine. Ils se justifient dès que le site porte de la logique métier, calcul de devis ou espace client par exemple, ce qui n'est pas le cas d'un site de présentation ordinaire. Savoir s'arrêter fait partie de la conception du dispositif. Un contrôle qui prend plus de temps à maintenir qu'il n'en fait gagner doit être retiré. Cette évaluation mérite d'être refaite une fois par an, les besoins du projet évoluant.
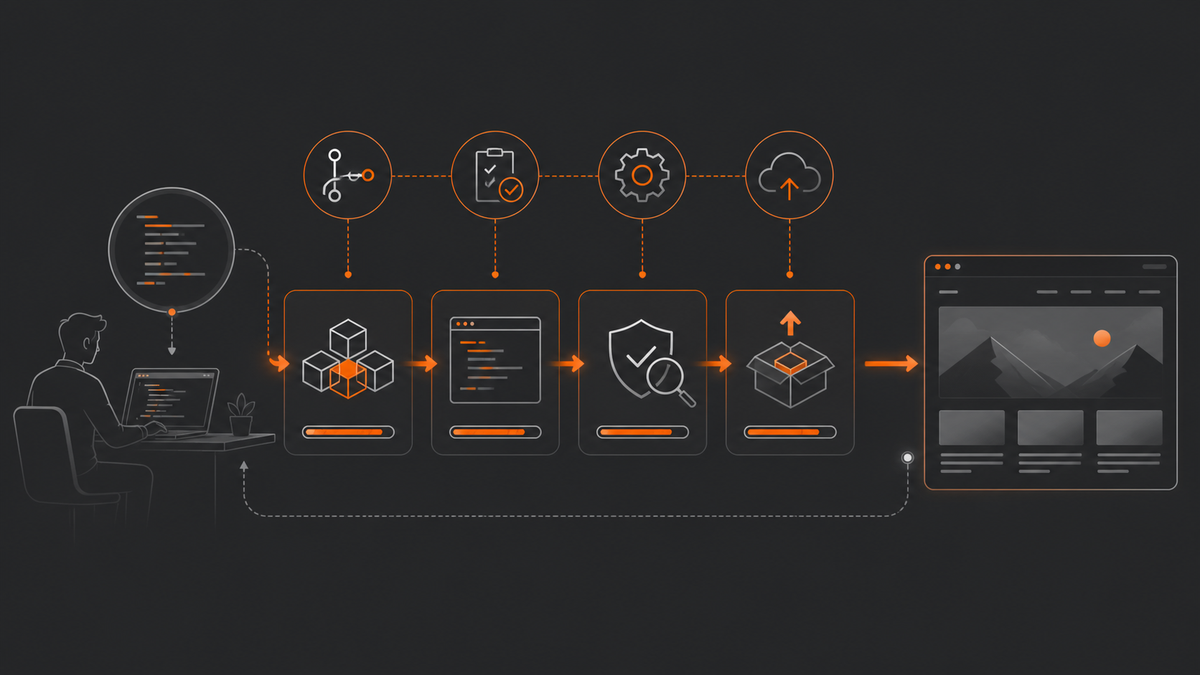
| Étape | Durée typique | Ce qu'elle attrape |
|---|---|---|
| Validation de syntaxe | Quelques secondes | Erreurs bloquantes |
| Analyse statique | Moins d'une minute | Constructions douteuses |
| Détection de secrets | Quelques secondes | Identifiants versionnés |
| Construction des ressources | Une à trois minutes | Erreurs de compilation |
| Tests fonctionnels minimaux | Une minute | Pages cassées |
| Déploiement | Une à deux minutes | Sans objet |
| Contrôle après déploiement | Quelques secondes | Mise en ligne incomplète |
Organiser le déploiement
C'est la partie qui apporte le plus de confort et celle qui demande le plus de précautions, puisqu'elle touche à la production.
Déclencher sur la bonne branche
La convention la plus simple déclenche le déploiement en production sur une branche principale et le déploiement en recette sur une branche de développement. Toute modification passe par une fusion, ce qui crée un point de décision explicite. Cette organisation à deux branches suffit très largement sur un site vitrine. Elle a le mérite d'être comprise immédiatement par toute personne rejoignant le projet. Ajouter des branches par fonctionnalité se justifie dès que plusieurs personnes travaillent en parallèle. En dessous, la complexité ajoutée dépasse le bénéfice obtenu.
Choisir le mode de transfert
Un transfert par protocole sécurisé, avec synchronisation différentielle, constitue la méthode la plus répandue et la plus simple. Elle n'envoie que ce qui a changé et elle peut supprimer ce qui a disparu, option à manier avec précaution car elle efface aussi ce qui n'a jamais été versionné. Un déploiement par récupération depuis le dépôt, exécuté sur le serveur, est plus élégant et demande un accès en ligne de commande. Le choix dépend surtout de ce que l'hébergement permet. Sur un mutualisé sans accès en ligne de commande, le transfert reste la seule option et il fonctionne parfaitement.
Protéger les identifiants
La clé permettant au système d'intégration de se connecter au serveur ne doit jamais figurer dans le dépôt. Les plateformes proposent un espace de secrets dédié, prévu exactement pour cela. Cette clé doit par ailleurs disposer des droits strictement nécessaires, ce qui exclut un compte administrateur. Une clé dédiée au déploiement, distincte de celle employée par les personnes, permet en outre de la révoquer sans gêner personne. Les précautions correspondantes sont détaillées dans notre article sur l'usage de add_ssh_keys sur CircleCI et la sécurisation des dépôts.
Exclure ce qui ne doit pas partir
Le dossier des médias, les fichiers de configuration propres au serveur et les répertoires de cache ne doivent pas être écrasés par le déploiement. Une liste d'exclusions, écrite une fois, évite le pire incident possible : effacer les contenus téléversés par le client. Cette liste doit être relue attentivement avant le premier déploiement réel. Une erreur à cet endroit ne pardonne pas. Un premier déploiement mené en mode simulation, sans écriture réelle, permet de vérifier la liste des fichiers concernés avant de valider.
Prévoir le retour arrière
Un déploiement qui casse le site doit pouvoir être annulé en une opération. La méthode la plus simple consiste à déployer dans un répertoire daté et à basculer un lien symbolique, ce qui rend le retour instantané. Sur un hébergement ne le permettant pas, redéployer la version précédente depuis le dépôt reste possible et prend quelques minutes. Cette procédure doit être écrite et testée avant d'en avoir besoin. La tester une fois, à froid, coûte dix minutes et évite de la découvrir au pire moment.
Vérifier après déploiement
Une requête sur la page d'accueil, immédiatement après la mise en ligne, confirme que le site répond. Ce contrôle tient en une ligne et il transforme un déploiement silencieux en opération vérifiée. Une notification en cas d'échec, vers une messagerie ou un canal d'équipe, complète le dispositif. Sans elle, un déploiement raté à vingt trois heures se découvre le lendemain matin. Une surveillance externe du site complète utilement ce contrôle ponctuel.
Répartition des incidents constatés avant mise en place, sur des sites vitrines maintenus par transfert manuel.
Vivre avec le dispositif
Une chaîne mise en place et jamais entretenue se dégrade, jusqu'à devenir un obstacle que l'on contourne en déployant à la main.
Garder les exécutions rapides
Une chaîne qui prend dix minutes décourage les petites modifications et pousse à regrouper les changements, ce qui augmente le risque de chaque déploiement. Viser moins de trois minutes est un objectif réaliste sur un site vitrine. La mise en cache des dépendances entre exécutions est le levier principal pour y parvenir. Ce réglage se fait une fois et il divise souvent la durée par deux. Retirer les étapes devenues inutiles au fil du temps contribue également à maintenir cette rapidité.
Ne pas ignorer les échecs
Un contrôle qui échoue régulièrement sans conséquence apprend à l'équipe à ignorer les alertes, ce qui rend l'ensemble inutile. Soit le contrôle est pertinent et il faut corriger la cause, soit il ne l'est pas et il faut le retirer. Cette discipline est ce qui distingue un dispositif vivant d'un décor. Elle demande de trancher rapidement plutôt que de laisser traîner. Un contrôle en échec depuis trois semaines est un contrôle mort, quelle que soit la bonne volonté affichée.
Documenter la chaîne
Une note expliquant ce que fait chaque étape, où sont stockés les secrets et comment revenir en arrière permet à quelqu'un d'autre d'intervenir. Sur un projet à une personne, cette note vaut surtout pour soi même dans six mois. C'est en général au moment d'un incident que l'on mesure ce qu'elle vaut. Elle doit vivre à côté du fichier de configuration de la chaîne, dans le dépôt lui même, ce qui garantit qu'elle suive le projet. Elle tient en quinze lignes. Y ajouter la date de la dernière relecture permet de savoir si elle décrit encore la réalité.
Surveiller le coût
Les plateformes proposent un quota gratuit généreux, largement suffisant pour un site vitrine, et facturent au delà. Une chaîne mal réglée, déclenchée sur chaque écriture plutôt que sur chaque fusion, peut consommer ce quota rapidement. Vérifier la consommation après quelques semaines évite la surprise. Un relevé mensuel les premiers mois suffit à connaître le rythme réel du projet. Ce réglage se corrige en une ligne de configuration. Restreindre le déclenchement aux branches concernées suffit dans la plupart des cas.
Faire évoluer progressivement
Une chaîne minimale qui fonctionne vaut mieux qu'une chaîne complète abandonnée. Ajouter un contrôle lorsqu'un incident révèle un manque est la meilleure façon de construire un dispositif adapté au projet. Cette approche par accumulation produit, au bout d'un an, exactement ce dont le projet a besoin, sans étape superflue ni manque criant. Elle évite surtout de recopier une configuration trouvée en ligne sans comprendre ce qu'elle fait. Une configuration comprise se corrige en deux minutes, une configuration copiée se contourne en désactivant tout.
Ne pas oublier la base de données
Le déploiement du code ne dit rien des évolutions de structure de la base, qui restent à traiter séparément. Sur un site vitrine, ces évolutions sont rares et se font à la main, ce qui est acceptable à condition d'être conscient. Sur un projet plus actif, un mécanisme de migrations versionnées devient nécessaire, avec des scripts numérotés appliqués dans l'ordre et une trace de ceux déjà exécutés. Poser cette limite explicitement évite de croire le déploiement plus complet qu'il ne l'est. Elle mérite de figurer dans la documentation de la chaîne, à côté de ce qu'elle fait effectivement. Cette documentation doit également indiquer ce que la chaîne ne fait pas, notamment la sauvegarde préalable et la vérification du rendu, points que chacun suppose traités ailleurs tant qu'ils ne sont pas écrits.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.