Réduire ce que l'on conserve d'une adresse réseau est devenu une pratique courante, et les recettes trouvées en ligne masquent souvent des différences importantes entre les techniques employées. Tronquer, hacher et saler ne produisent pas les mêmes propriétés, ne protègent pas contre les mêmes attaques et ne laissent pas les mêmes usages disponibles. Cet article détaille chacune de ces opérations sur le plan technique, avec les paramètres qui comptent et les erreurs qui annulent la protection. La question de la politique de conservation associée est traitée séparément dans notre article sur la manière de journaliser les accès sans conserver d'adresse IP en clair.
Ce que l'on cherche à empêcher
Avant de choisir une technique, il faut préciser contre quoi on se protège, sans quoi la comparaison n'a pas de sens. Trois menaces distinctes existent et elles n'appellent pas les mêmes réponses. La première est la lecture directe : quelqu'un accédant aux journaux, légitimement ou non, y lit des adresses identifiantes. La deuxième est la corrélation : rapprocher plusieurs traces pour reconstituer le parcours d'une personne à travers le temps. La troisième est la réidentification : retrouver l'adresse d'origine à partir de la valeur transformée, par calcul ou par recoupement. Confondre ces trois menaces conduit à des choix incohérents, une technique excellente contre l'une pouvant être sans effet contre les autres.
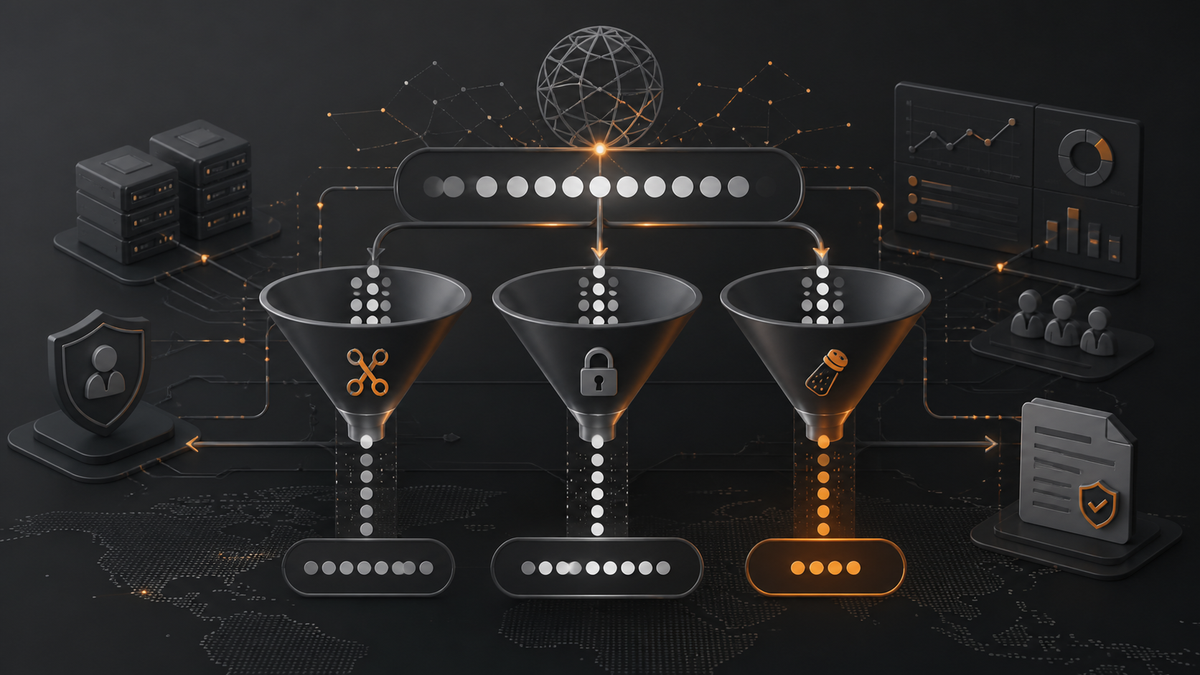
La troncature répond bien à la première menace et partiellement à la troisième, tout en dégradant la deuxième de façon parfois indésirable. Le hachage salé répond bien à la première et à la troisième, tout en préservant intégralement la deuxième, ce qui est un avantage pour la sécurité et une limite pour la protection des personnes. Cette tension entre corrélation utile et corrélation intrusive est le cœur du sujet, et elle explique qu'aucune technique ne soit universellement supérieure. Le choix dépend donc de ce que l'on veut pouvoir continuer à faire, question à laquelle il faut répondre avant d'ouvrir la documentation d'un outil.
Il faut aussi mesurer ce qui rend une adresse identifiante. Prise isolément, elle désigne une ligne d'abonnement, ce qui suffit rarement à nommer quelqu'un sans le concours d'un opérateur. Croisée avec un horodatage précis, une page consultée et un identifiant de session, elle devient nettement plus révélatrice. La question n'est donc pas seulement de transformer l'adresse mais de considérer l'ensemble des champs conservés dans la même ligne de journal. Une adresse tronquée à côté d'un identifiant de compte n'apporte aucune protection. Le raisonnement doit donc porter sur la ligne complète, et non sur le seul champ que l'on a décidé de traiter.
Enfin, la transformation doit intervenir le plus tôt possible dans la chaîne. Une adresse écrite en clair puis anonymisée par un traitement nocturne a existé en clair pendant vingt quatre heures, dans les journaux, dans les sauvegardes et dans tout ce qui les a lus. La règle est donc de transformer à l'écriture, avant tout stockage, ce qui déplace le travail vers la configuration du serveur ou vers l'entrée de l'application. Ce déplacement est le principal obstacle pratique rencontré, notamment sur les hébergements où la configuration du serveur n'est pas accessible.
La troncature en pratique
La troncature consiste à mettre à zéro une partie des bits de l'adresse, ce qui la ramène à un réseau. C'est l'opération la plus simple, la plus rapide et celle qui est proposée nativement par le plus grand nombre d'outils. Sa mise en œuvre demande néanmoins quelques précisions que les configurations par défaut ne donnent pas toujours.
Sur une adresse de quatrième génération, la pratique la plus répandue met à zéro le dernier octet, ce qui laisse un réseau de deux cent cinquante six adresses possibles. Cette granularité est suffisante dans la plupart des contextes et elle reste faible sur un site à faible fréquentation : si trois personnes seulement visitent le site depuis un réseau donné, le regroupement ne protège pas beaucoup. Une troncature plus agressive, portant sur les deux derniers octets, élargit le groupe à soixante cinq mille adresses et supprime toute possibilité de localisation fine. Elle rend en revanche impossible toute distinction entre visiteurs d'une même région, ce qui fausse les comptages de visiteurs uniques.
Le choix du masque doit donc tenir compte du volume de trafic. Un site recevant plusieurs milliers de visiteurs par jour obtient une protection réelle avec un masque léger, la dilution étant assurée par le nombre. Un site confidentiel, consulté par quelques dizaines de personnes, doit tronquer davantage pour que le regroupement ait un sens. Ce raisonnement, emprunté aux techniques de généralisation, est rarement appliqué et il change pourtant la valeur de la protection. Il conduit parfois à conclure qu'aucune troncature n'apporte de garantie suffisante sur un site très peu fréquenté, ce qui oriente alors vers le hachage salé ou vers la suppression pure.
Sur une adresse de sixième génération, la situation diffère profondément et les configurations par défaut sont souvent inadaptées. La structure attribue fréquemment un préfixe entier à un seul abonné, ce qui signifie que mettre à zéro les derniers bits ne change rien à l'identification. La pratique établie conserve les quarante huit à soixante quatre premiers bits et met le reste à zéro. Beaucoup d'outils appliquent la même logique qu'en quatrième génération, ce qui laisse en pratique l'abonné parfaitement identifiable. La part de trafic concernée dépasse aujourd'hui la moitié des visites sur beaucoup de sites français, ce qui rend ce point tout sauf marginal.
La vérification est immédiate : il suffit de regarder une ligne de journal correspondant à un visiteur en sixième génération et de compter ce qui subsiste après transformation. Ce contrôle prend dix secondes et il est presque toujours sauté. Il révèle régulièrement que la moitié du trafic n'est pas anonymisée du tout, ce qui vide le dispositif de son sens. Corriger le masque appliqué demande en général une seule ligne de configuration.
| Technique | Réidentification | Corrélation | Localisation |
|---|---|---|---|
| Adresse en clair | Directe | Exacte | Précise |
| Troncature d'un octet | Difficile | Approchée | Ville ou région |
| Troncature de deux octets | Très difficile | Très approchée | Région ou pays |
| Hachage sans sel | Réalisable par calcul | Exacte | Aucune |
| Hachage avec sel fixe | Difficile sans le sel | Exacte et permanente | Aucune |
| Hachage avec sel tournant | Difficile sans le sel | Limitée à la période | Aucune |
Le hachage et son piège principal
Le hachage transforme l'adresse en une empreinte de longueur fixe. L'opération est à sens unique au sens mathématique, ce qui conduit beaucoup d'implantations à la considérer comme suffisante. Elle ne l'est pas, et la raison est purement combinatoire.
L'espace des adresses de quatrième génération compte un peu plus de quatre milliards de valeurs. Calculer l'empreinte de chacune d'elles et constituer une table de correspondance demande quelques heures sur du matériel ordinaire et occupe un volume de stockage modeste. Quiconque obtient un journal d'empreintes non salées retrouve donc les adresses d'origine sans difficulté. Le hachage seul n'apporte, dans ce contexte, qu'une protection cosmétique contre une lecture directe. La situation est encore plus nette qu'avec les mots de passe, dont l'espace de valeurs possibles est infiniment plus vaste.
L'ajout d'un sel, chaîne aléatoire secrète concaténée à l'adresse avant hachage, rend ce calcul impraticable tant que le sel reste inconnu. La protection repose alors entièrement sur la confidentialité de cette valeur, ce qui déplace le problème vers la gestion des secrets plutôt qu'il ne le supprime. Un sel présent dans un fichier de configuration versionné, ou inclus dans les sauvegardes accessibles, annule l'ensemble du dispositif. Il doit être traité avec le même soin qu'une clé de chiffrement. Un stockage dans un gestionnaire de secrets, ou à défaut dans une variable d'environnement hors du dépôt, constitue le minimum acceptable.
Le choix de l'algorithme compte moins qu'on ne le croit dans ce contexte, à condition d'écarter les fonctions anciennes dont les faiblesses sont connues. Une fonction de la famille moderne convient parfaitement. Employer une fonction de dérivation lente, conçue pour les mots de passe, serait ici contre productif : le coût de calcul se paierait sur chaque requête sans apporter de protection supplémentaire, l'entropie de l'entrée étant de toute façon faible. C'est un point où l'intuition trompe, la lenteur étant une qualité pour les mots de passe et un défaut ici.
La longueur conservée de l'empreinte mérite enfin une décision. Conserver l'empreinte complète est le choix par défaut et il n'y a aucune raison de la tronquer, sauf contrainte de stockage sur de très gros volumes. Une troncature de l'empreinte augmente les collisions, ce qui dégrade la distinction entre visiteurs sans améliorer la protection de façon significative. Une empreinte tronquée à huit caractères produit des collisions détectables dès quelques dizaines de milliers de valeurs.
Répartition constatée lors de revues techniques portant sur la journalisation de sites professionnels.
La rotation du sel
C'est le raffinement qui change la nature de la protection et il est étonnamment peu répandu. Un sel fixe permet de corréler indéfiniment : deux visites du même visiteur, à trois ans d'intervalle, produisent la même empreinte. Cette permanence est utile pour certaines analyses et elle constitue exactement le type de suivi que l'anonymisation cherchait à limiter.
Changer le sel à intervalle régulier, chaque jour ou chaque semaine, brise cette continuité. À l'intérieur d'une période, la corrélation reste parfaite, ce qui couvre les besoins de sécurité et de comptage. Au delà, elle devient impossible, y compris pour celui qui détient les journaux. La durée de la période se choisit en fonction du plus long usage légitime : compter des visiteurs uniques sur un mois impose un sel mensuel, détecter des tentatives de connexion se contente d'un sel quotidien. Une période trop courte casse des analyses légitimes, une période trop longue affaiblit la protection : c'est un arbitrage à poser explicitement plutôt qu'à subir.
La destruction de l'ancien sel est l'étape qui donne son sens à l'opération. Conserver l'historique des sels permettrait de recalculer les correspondances a posteriori, ce qui annule le bénéfice. Cette destruction doit être automatique et vérifiée, et elle doit couvrir les sauvegardes du système de gestion des secrets. C'est le point sur lequel les implantations sont le plus souvent incomplètes. Beaucoup conservent les sels par prudence, sans mesurer qu'ils annulent ainsi tout l'intérêt de la rotation.
La génération du sel doit employer une source d'aléa cryptographique, jamais une fonction de hasard ordinaire ni une valeur dérivée de la date. Un sel prévisible équivaut à un sel connu. Sa longueur doit être suffisante, trente deux octets constituant un choix raisonnable et sans coût. Ces précautions sont les mêmes que pour n'importe quel secret applicatif, ce qui permet de réutiliser les mécanismes déjà en place. Il n'y a donc aucune raison d'écrire un mécanisme spécifique pour cette valeur.
Sur une infrastructure comportant plusieurs serveurs, le sel doit être partagé pour que les empreintes soient cohérentes, ce qui suppose un mécanisme de distribution. Un sel différent par machine produit des empreintes incomparables et rend le comptage faux. Ce point se découvre en général après le déploiement, lorsque les chiffres cessent d'avoir un sens. Le symptôme est reconnaissable : le nombre de visiteurs uniques est multiplié par le nombre de serveurs applicatifs.
Le risque de réidentification par recoupement
Une adresse transformée ne protège que si le reste de la ligne ne trahit pas la personne. Ce point est le plus souvent négligé et il annule régulièrement tout le travail effectué en amont.
Une ligne comportant une empreinte, un horodatage à la milliseconde, un identifiant de session, un agent de navigateur détaillé et une page consultée constitue un ensemble hautement identifiant. L'agent seul, avec ses versions précises et ses particularités, distingue déjà une part significative des visiteurs. Ajouter la résolution d'écran ou la liste des polices installées, comme le font certains outils, produit une empreinte de navigateur plus identifiante que l'adresse elle même. Le travail d'anonymisation devient alors purement décoratif, ce qui est pire qu'une absence de traitement, puisqu'il donne un faux sentiment de conformité.
La réponse consiste à réduire l'ensemble des champs conservés, et pas seulement l'adresse. Généraliser l'horodatage à la seconde plutôt qu'à la milliseconde, tronquer l'agent à sa famille et sa version majeure, ne pas conserver d'identifiant de session dans les journaux d'accès : ces trois mesures réduisent fortement le pouvoir identifiant de la ligne. Elles coûtent quelques réglages dans le format de journalisation. Se demander, champ par champ, à quel usage il sert réellement conduit souvent à en supprimer plusieurs sans regret.
Le cas des visiteurs authentifiés demande un traitement particulier. Une ligne comportant un identifiant de compte n'a évidemment rien d'anonyme, quelle que soit la transformation appliquée à l'adresse. Ces lignes relèvent d'un autre régime, avec leurs propres finalités et leurs propres durées de conservation. Les mélanger dans le même fichier que les accès anonymes complique inutilement le traitement. Les séparer dès l'écriture, dans deux fichiers distincts, simplifie considérablement la gestion des durées de conservation.
Il faut enfin rester lucide sur ce que l'anonymisation garantit. Une transformation bien menée réduit très fortement le risque et elle ne le supprime pas absolument, notamment lorsque le volume de trafic est faible ou que d'autres sources permettent le recoupement. Le vocabulaire employé compte : parler de pseudonymisation plutôt que d'anonymisation est souvent plus exact, et la qualification juridique de ces opérations relève d'un conseil compétent. Nous ne sommes pas juristes et le cadre applicable est rappelé dans notre article sur le RGPD et ce que dit la loi pour être en conformité.
Mettre en œuvre au bon endroit
La technique retenue doit être appliquée à l'endroit le plus en amont possible, ce qui varie selon l'architecture et selon les outils employés.
Au niveau du serveur web, un module dédié permet de transformer l'adresse avant l'écriture des journaux, avec un masque configurable. C'est la solution la plus propre, puisqu'elle couvre l'ensemble des accès, fichiers statiques compris, et qu'elle ne dépend d'aucun code applicatif. Elle demande un accès à la configuration du serveur, ce que tous les hébergements ne permettent pas. Sur un hébergement infogéré, la demande peut être adressée au prestataire, ce type de réglage étant courant. La plupart des hébergeurs français le proposent d'ailleurs par défaut depuis plusieurs années.
Au niveau de l'application, la transformation se fait à l'entrée, en remplaçant la variable contenant l'adresse par sa version transformée. Toutes les extensions et tout le code bénéficient alors de la correction sans modification. Cette approche est simple et elle ne couvre évidemment pas les journaux du serveur, qui restent à traiter séparément. La combinaison des deux niveaux est la configuration complète. Elle demande de veiller à ce que les deux emploient la même transformation, faute de quoi les corrélations entre les deux sources deviennent impossibles.
Les outils de mesure d'audience proposent en général une option d'anonymisation, dont il vaut la peine de vérifier ce qu'elle fait exactement. Certaines transforment l'adresse avant transmission, d'autres après réception par le service, ce qui n'est pas du tout équivalent du point de vue de ce qui quitte le navigateur du visiteur. La documentation de l'outil répond à cette question et elle est rarement consultée. La notion même d'adresse et sa structure sont détaillées dans notre article sur l'adresse IPv4, sa définition et son fonctionnement.
Derrière un proxy inverse ou un réseau de diffusion, l'adresse réelle arrive dans un en tête plutôt que dans la connexion. La transformation doit alors porter sur la valeur extraite de cet en tête, après vérification que la requête provient bien d'un intermédiaire de confiance. Une implantation transformant l'adresse de connexion, celle du proxy, produit une empreinte identique pour tous les visiteurs, ce qui se remarque immédiatement dans les statistiques.
Reste à vérifier que le dispositif fonctionne. Le contrôle consiste à se connecter depuis une adresse connue, en quatrième puis en sixième génération, et à examiner ce qui apparaît dans les journaux. Ce test prend cinq minutes et il attrape la totalité des erreurs de configuration courantes. Le refaire après chaque changement d'hébergement ou de configuration serveur évite les régressions silencieuses, qui sont la règle sur ce type de réglage.
💬 0 commentaires
✍️ Laisser un commentaire
Créez un compte gratuit ou connectez-vous pour commenter.